사람 대신 AI가 가르친다 — Laya 교사 증류로 블로그 주제 고르기 실험
지난 글에서 오픈소스 판단 모델 Laya를 MacBook에서 학습시켜 봤습니다. 결론은 “학습하면 쓸 만하다”였는데, 남는 질문이 하나 있었습니다. 정답 데이터는 누가 만드나? 수백 개에 사람이 일일이 정답을 다는 건 현실적이지 않습니다.
그래서 이번에는 Claude가 교사가 되어 정답을 달고, 그걸로 Laya를 가르치는 방식(교사 증류, distillation)을 실제로 해 봤습니다. 과제는 이 블로그에 딱 맞는 걸 골랐습니다. 매주 유튜브 트렌딩 영상 중 “단독 포스트로 쓸 만한 영상”을 골라 주는 선별기입니다.
한 줄 요약
- Claude(교사)가 유튜브 영상 424개에 “포스트감인가”를 확률로 달고, 그 확률을 그대로 Laya 학습 목표로 썼습니다.
- 학습 전 Laya는 거의 모든 영상에 “포스트감 100%”를 줘서 구분을 못 했습니다(AUROC 0.697). 학습 후 AUROC 0.975가 됐습니다.
- 실제로 이 블로그에 포스트를 쓴 영상 5개는 시험 40개 중 4·9·11·18·24위 → 2·3·4·5·6위로 올라왔습니다.
- 지금은 주간 트렌딩 리포트 끝에 “Laya 추천 상위 5개”가 자동으로 붙습니다.
이 실험을 하게 만든 영상 두 개
1) 에이전트 스킬 고르기에 Laya를 쓴 실험
Tonbi’s AI Garage의 영상입니다. 자기 Hermes Agent에 스킬이 122개 있는데, 메시지마다 비싼 최상위 모델이 이 중에서 고르는 건 낭비라고 봤습니다. 그래서 작은 판단 모델이 후보를 3~10개로 줄여 주는 역할을 맡게 했습니다.
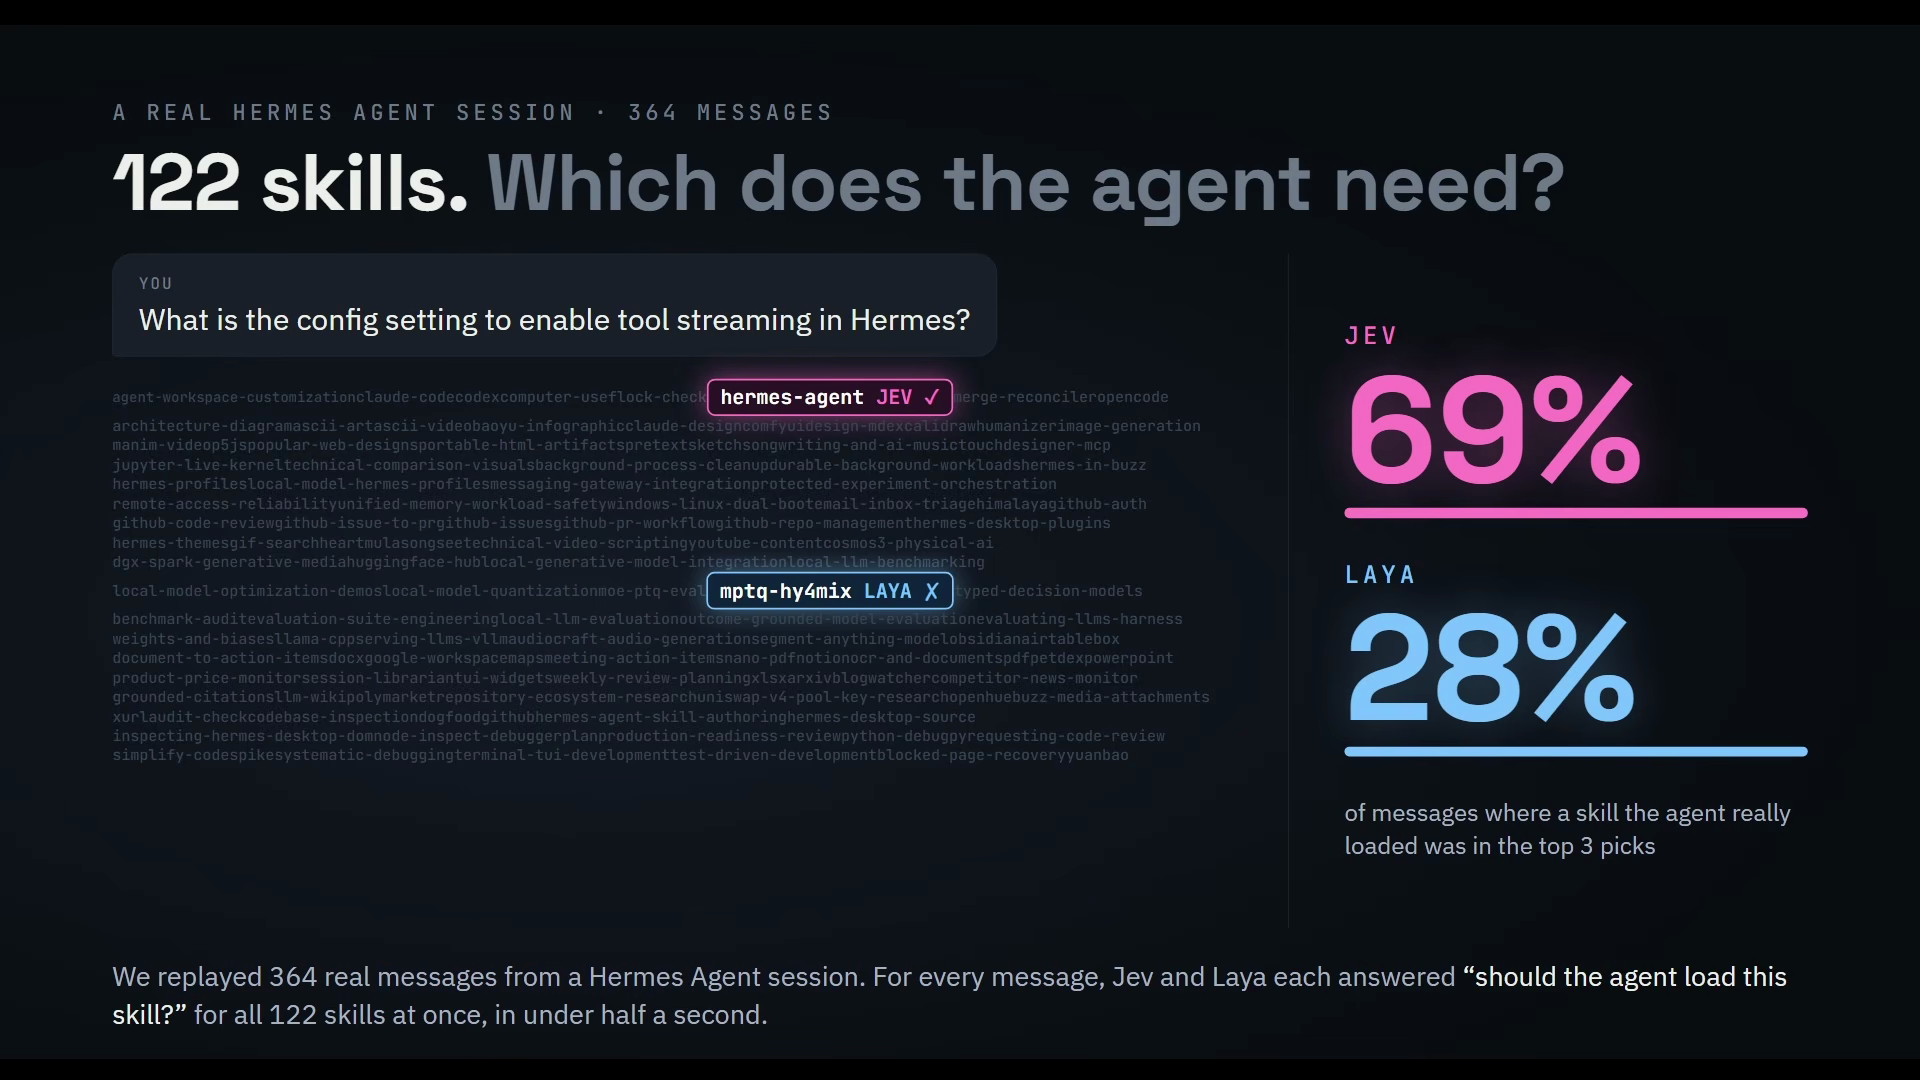
눈여겨볼 점은 정답을 사람이 달지 않았다는 겁니다. 에이전트가 실제로 불러온 스킬 기록이 곧 정답입니다. Laya는 선택지를 20개 정도까지만 잘 다루기 때문에, 122개를 고르는 대신 스킬마다 “불러야 하나?”를 예/아니오로 물어서 한계를 피했습니다.
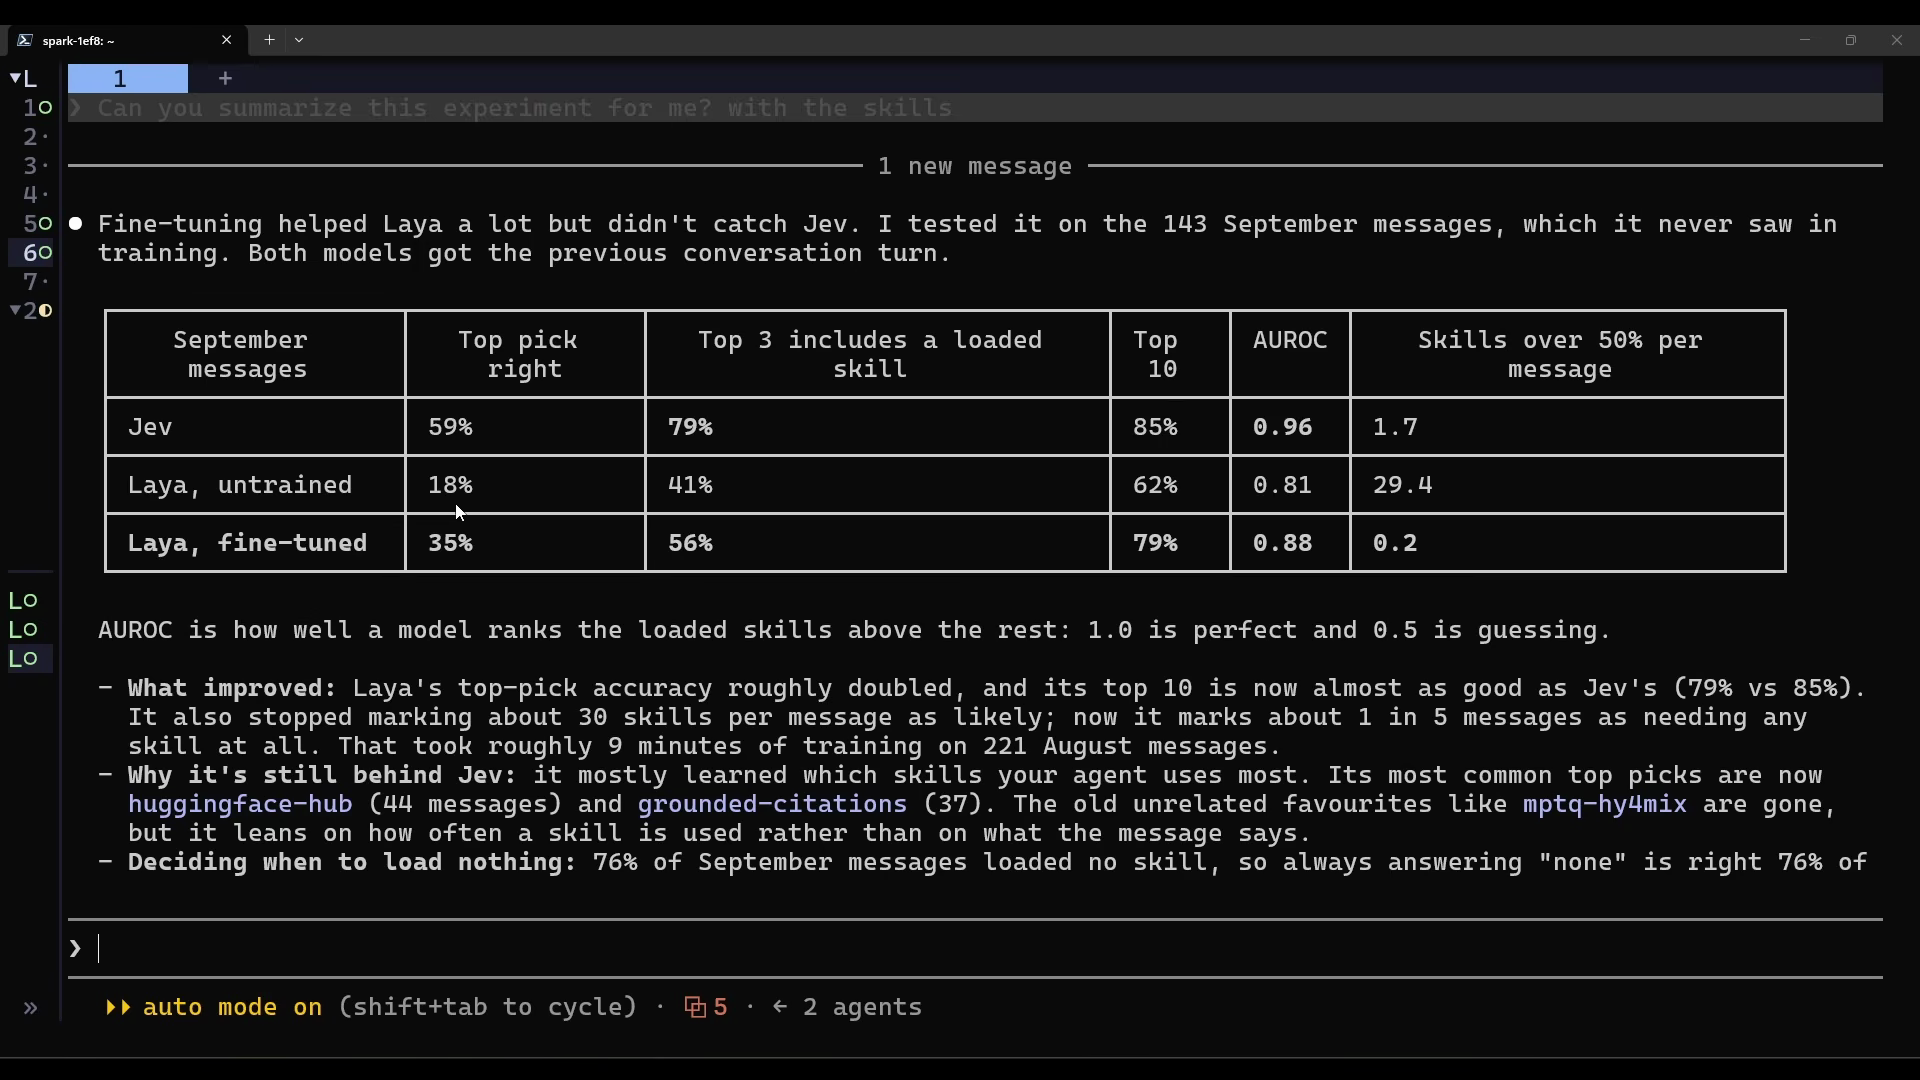
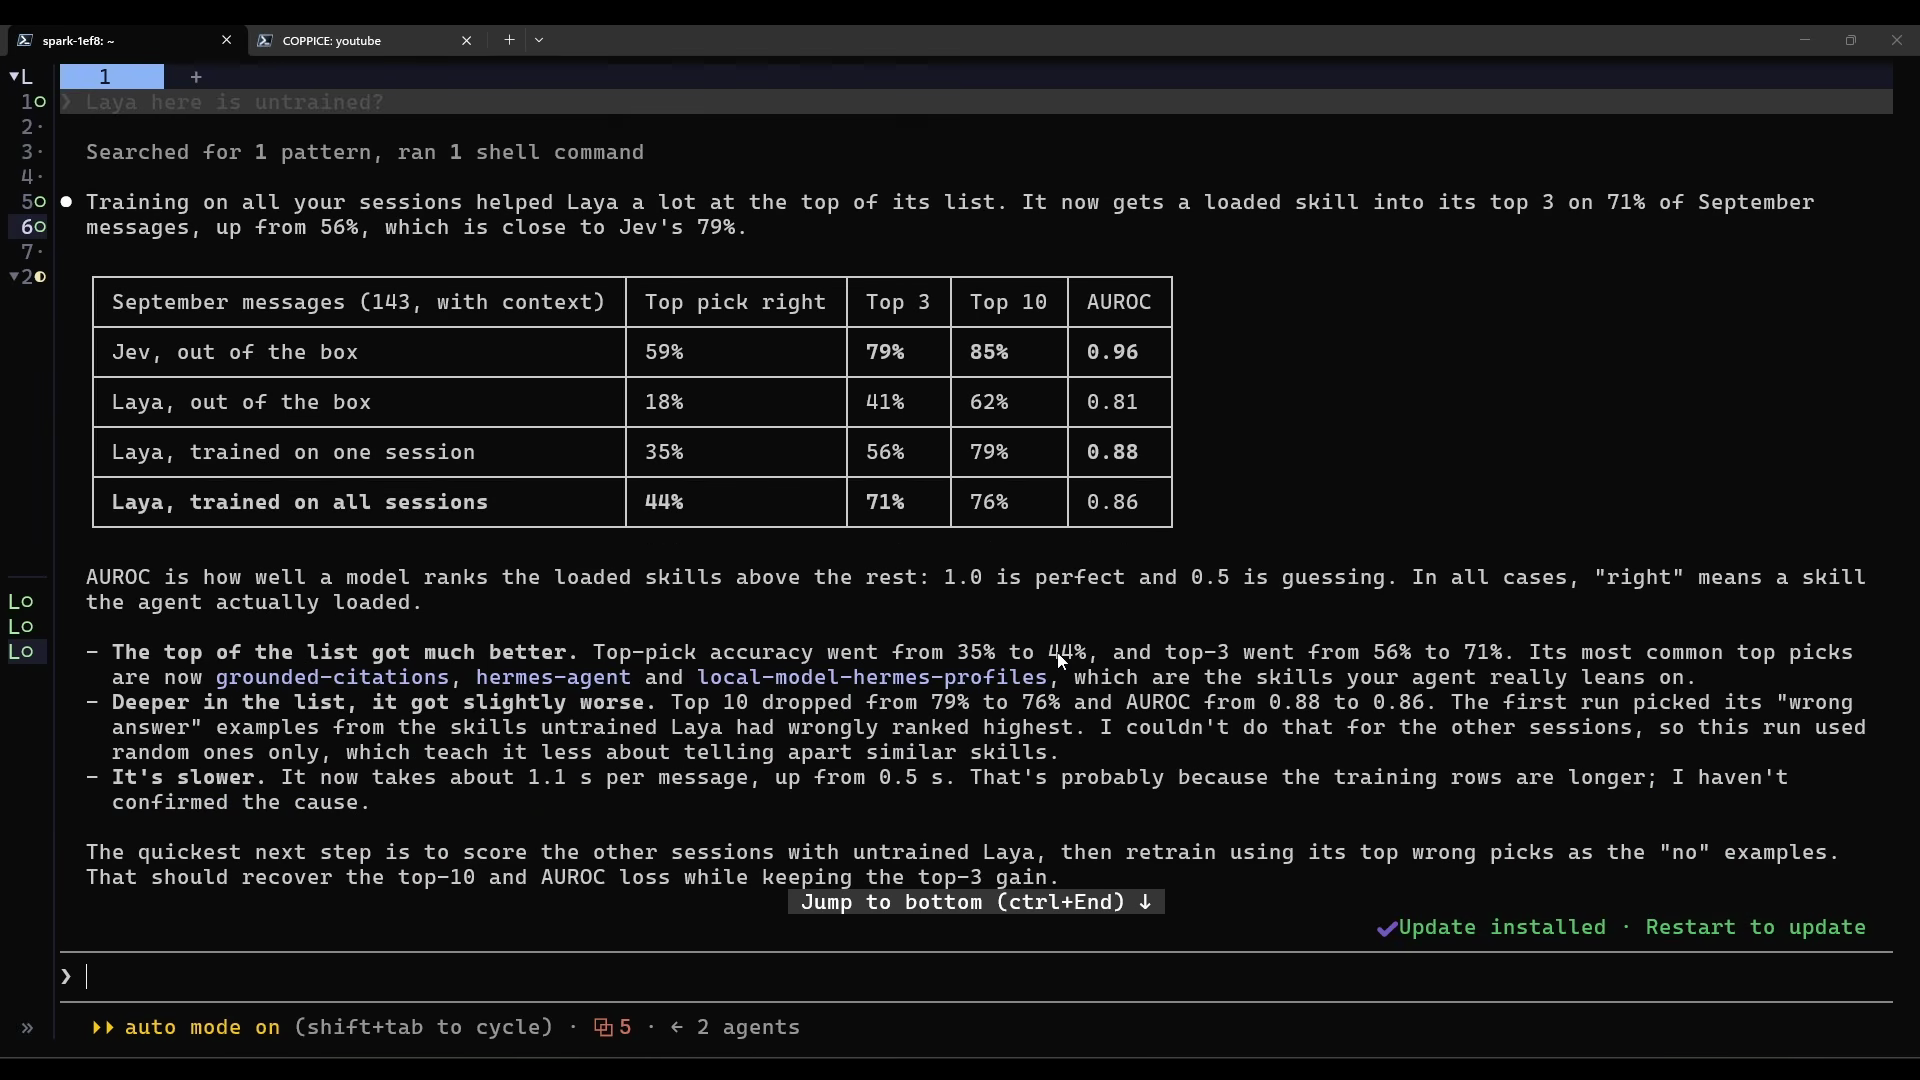
| 9월 메시지 143개 | 1순위 적중 | 상위 3 | 상위 10 | AUROC |
|---|---|---|---|---|
| Jev (학습 없음) | 59% | 79% | 85% | 0.96 |
| Laya 학습 전 | 18% | 41% | 62% | 0.81 |
| Laya, 세션 하나로 학습 | 35% | 56% | 79% | 0.88 |
| Laya, 전체 세션으로 학습 | 44% | 71% | 76% | 0.86 |
데이터를 늘리자 상위권은 좋아졌지만 상위 10개는 오히려 떨어졌습니다. 지난 글에서 데이터를 늘렸더니 정확도가 떨어진 것과 같은 현상입니다.
2) 데모가 건너뛴 정확도 이야기
AI WITH Rithesh의 영상은 커뮤니티 테스트를 모아 “속도 데모 말고 정확도를 재면 어떻게 되나”를 정리합니다.
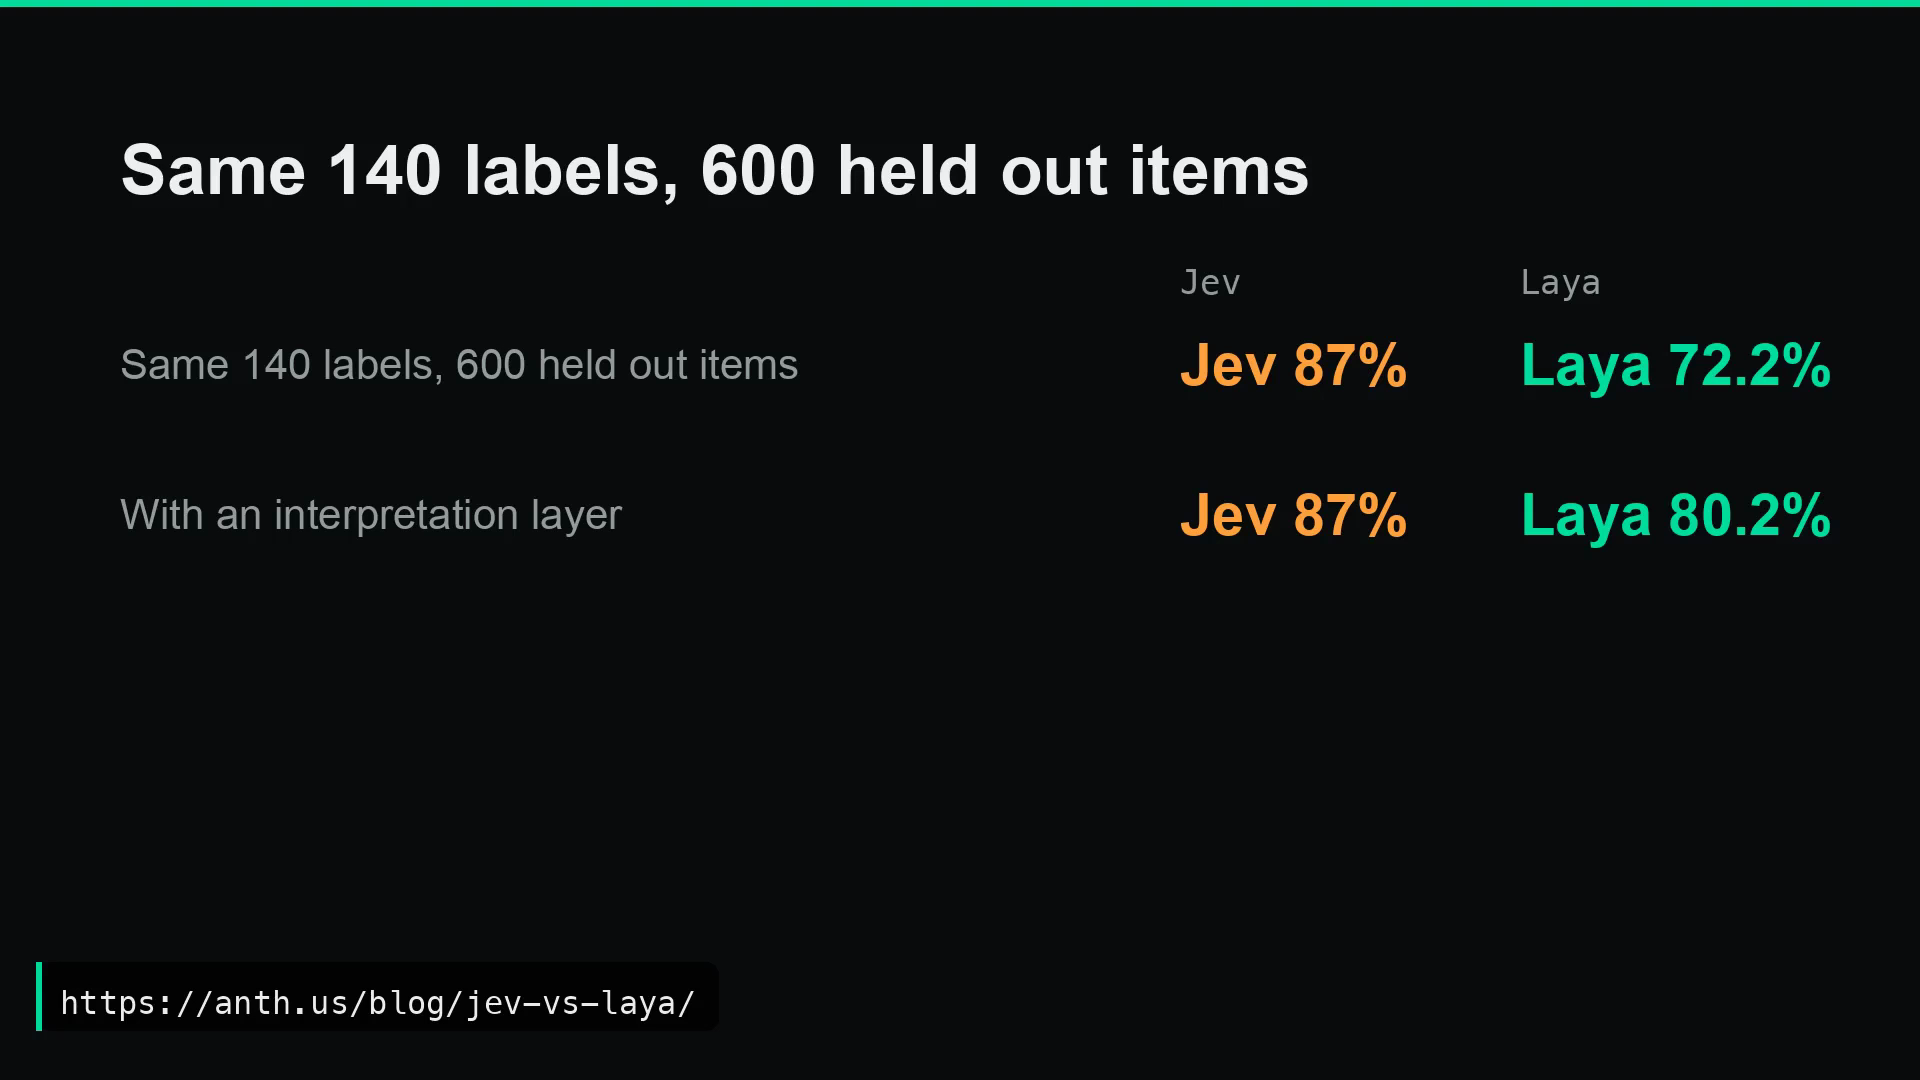
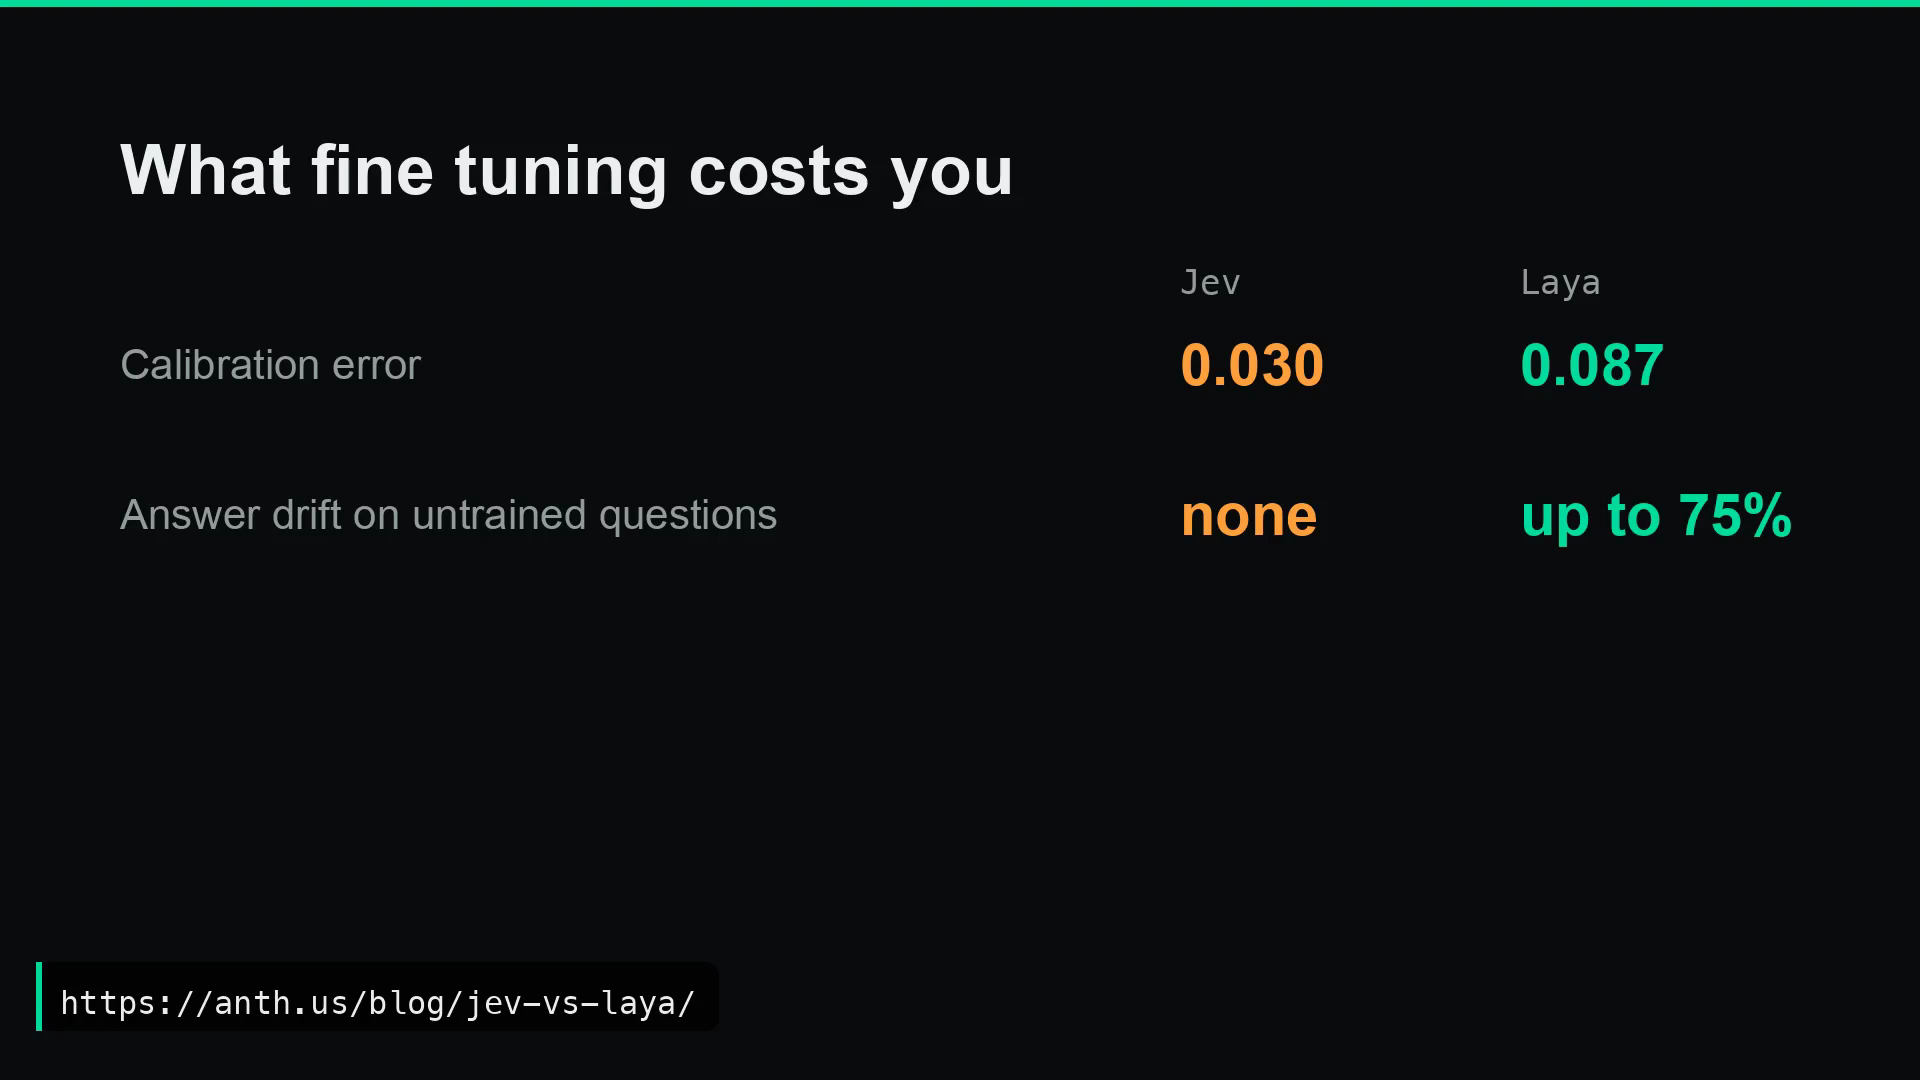
학습 전에는 Jev가 확실히 앞섭니다. 그런데 학습하면 Laya가 89.6%로 Jev를 넘습니다. 대가도 있습니다.
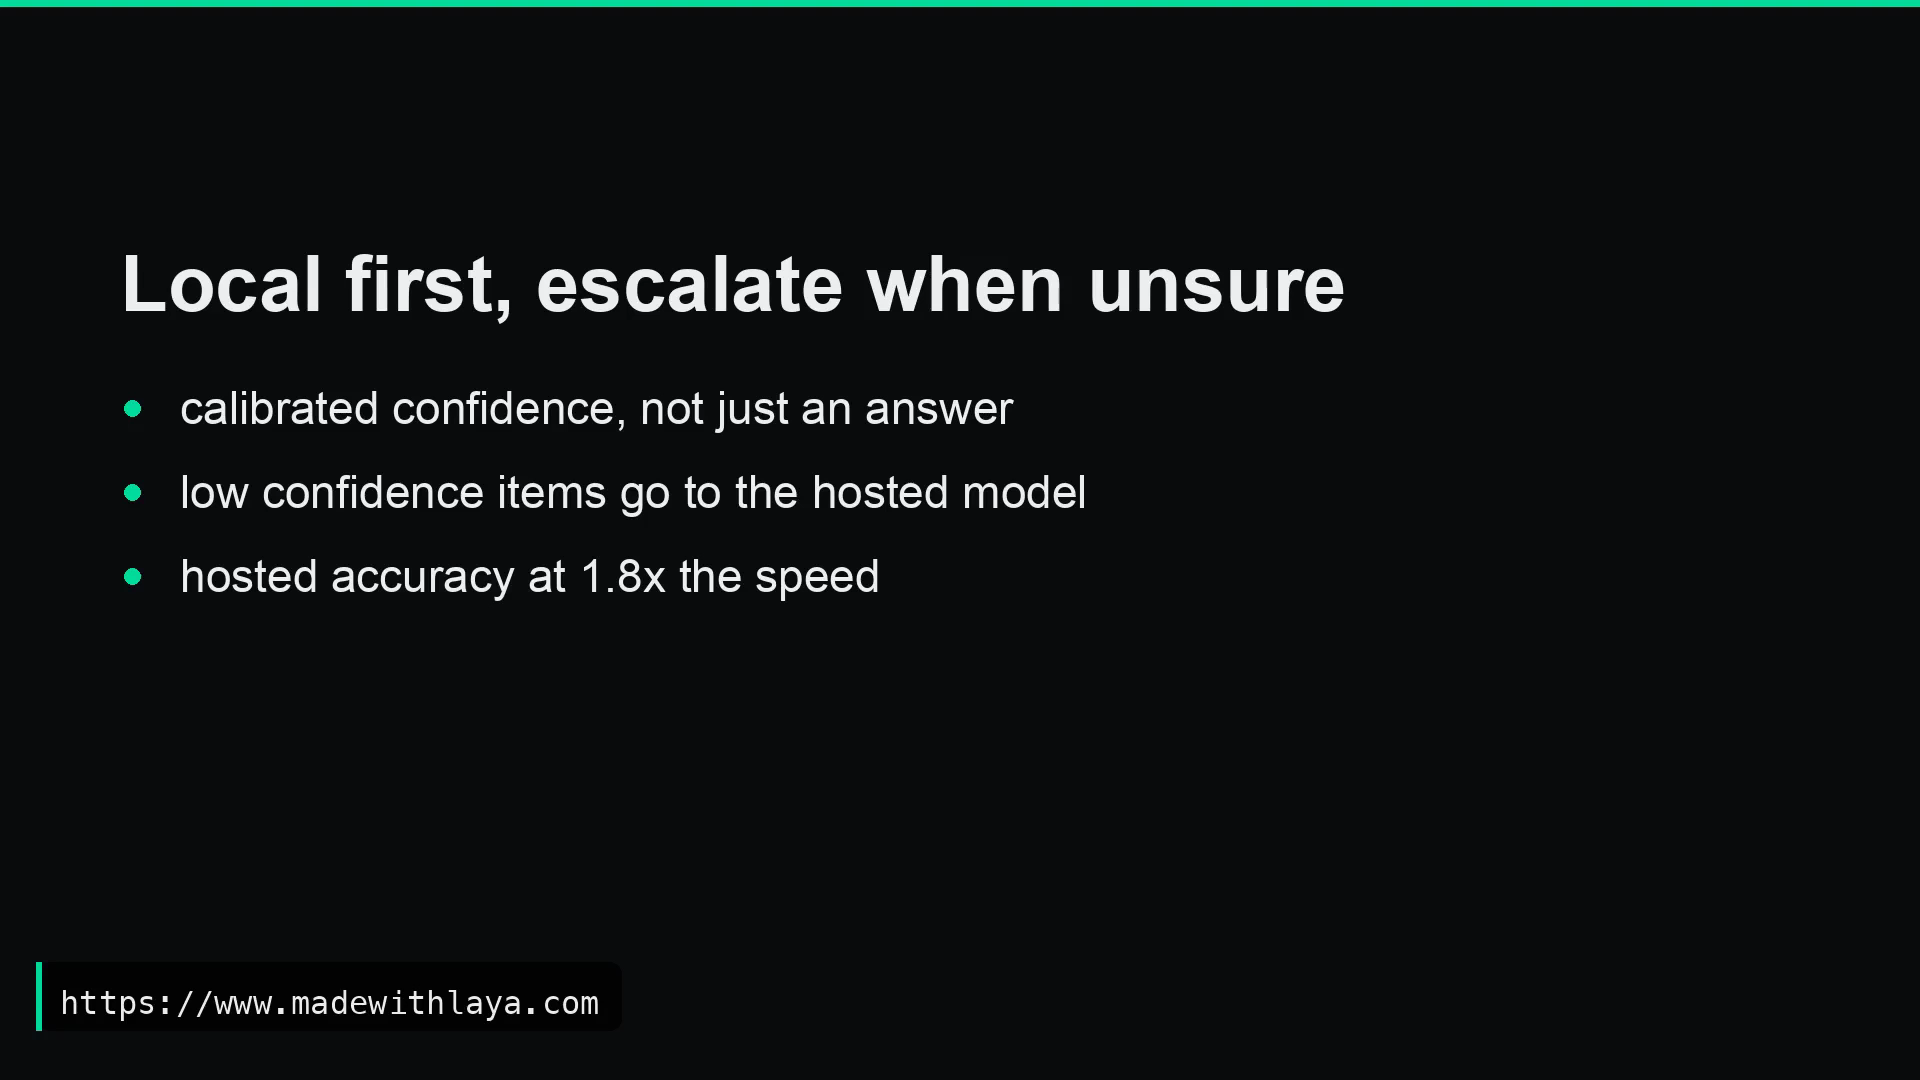
그리고 영상이 추천하는 운영 방식이 이번 실험의 힌트가 됐습니다.
두 영상을 합치면 결론이 하나로 모입니다. Laya는 학습이 필수이고, 정답은 사람이 아니어도 된다. 실제 기록(영상 1)이나 더 큰 모델의 판단(영상 2의 유료 모델)이 정답 역할을 할 수 있습니다.
사람 없이 정답을 만드는 방법 4가지
| 방법 | 정답을 누가 다나 | 맞는 상황 |
|---|---|---|
| 교사 증류 | 더 큰 AI가 정답(확률)을 단다 | 데이터는 있는데 정답이 없을 때 |
| 사용 기록 | 이미 일어난 행동이 정답 (영상 1) | 기록이 쌓여 있을 때 |
| AI 합성 데이터 | AI가 문장과 정답을 함께 만든다 | 데이터 자체가 없을 때. 표현을 다양하게 만들어야 함 |
| 확신도 단계 처리 | 확신이 낮은 것만 큰 AI가 답하고, 그걸 모아 재학습 | 운영하면서 계속 개선할 때 |
공식 Laya 학습 데이터도 교사 방식입니다. README에 “teacher self-agreement ceiling 0.735”라는 말이 나오는데, 정답을 교사 모델이 달았고 그 교사가 스스로와 일치하는 비율이 상한이라는 뜻입니다.
이번 실험은 교사 증류를 골랐습니다. 사용 기록(포스트를 쓴 영상)은 11개뿐이라 정답으로는 부족했기 때문입니다. 공개된 유튜브 정보만 다루니 외부 AI에 보내도 문제가 없다는 점도 이유였습니다. 회사 메일 같은 민감한 데이터라면 이 방법은 쓰면 안 됩니다.
실험 설계
1. 후보 모으기
블로그 트렌딩 스크립트가 보는 화이트리스트 채널 13개(국내 6, 해외 7)의 최근 120일 업로드를 모았습니다. 쇼츠를 빼니 424개(국내 211, 해외 213)였습니다.
기존 스크립트는 검색 API(search.list, 1회 100 units)를 쓰는데, 이번에는 채널 업로드 목록(playlistItems.list, 1회 1 unit)을 썼습니다. 424개를 모으는 데 약 39 units밖에 들지 않았습니다.
2. 판단 기준과 질문
기존 포스트 40개를 보고 이 블로그가 다루는 영상의 기준을 글로 정리했습니다. 실제로 단독 포스트를 쓴 영상은 Orca IDE, ego-browser, herdr, Jev 테스트, Laya 같은 도구 리뷰, 설치 가이드, 새 모델 직접 테스트였고, 뉴스 모음이나 인터뷰, 자극적인 제목뿐인 영상은 쓰지 않았습니다.
Laya에 던질 질문은 두 개입니다. 한 번의 계산으로 둘 다 답합니다.
1
2
3
4
5
6
7
8
9
10
11
QUESTIONS = {
    "post_worthy": {"type": "noul",
        "instructions": "이 유튜브 영상을 바탕으로 한국어 기술 블로그에 단독 포스트(도구 리뷰, 설치·사용 가이드, "
                        "새 모델·기술 직접 테스트)를 쓸 만한가? 뉴스 모음, 인터뷰, 전망, 자극적 제목뿐인 영상은 아니다."},
    "kind": {"type": "choice", "instructions": "이 영상의 유형은?",
        "criteria": {"tool_review": "특정 도구·제품·서비스 소개나 리뷰",
                     "tutorial": "설치·설정·사용법을 따라 하는 실습",
                     "model_test": "새 모델·기술을 직접 테스트하거나 원리 분석",
                     "news": "여러 소식, 발표, 업계 동향, 루머",
                     "talk": "인터뷰, 팟캐스트, 의견, 전망, 기타"}},
}
Laya에 넘기는 입력은 영상 정보 세 줄입니다.
1
2
3
채널: 코드팩토리
제목: Orca IDE 기~모~링!
설명: (설명 앞 300자)
3. 교사가 정답 달기
Claude 하위 에이전트 4개가 106개씩 나눠 맡아, 판단 기준 문서를 읽고 영상마다 정답을 달았습니다. 핵심은 0/1이 아니라 확률로 달게 한 것입니다. “확실히 아님 0.05, 애매 0.3, 아마 맞음 0.7, 확실 0.95”처럼요.
424개 중 77개(18%)가 “포스트감”(0.5 이상)으로 나왔습니다. 채널마다 차이가 컸습니다.
| 채널 | 포스트감 / 전체 |
|---|---|
| 코드팩토리 | 28 / 51 |
| Jay Choi (인디해커) | 16 / 26 |
| Matthew Berman | 9 / 61 |
| 노마드 코더 | 7 / 9 |
| 조코딩 | 4 / 69 |
| Latent Space, David Shapiro, AI Explained | 0 |
4. 학습 데이터: 교사의 확률을 그대로 목표로
Laya 학습 스크립트는 정답을 확률 분포로 받습니다. 그래서 교사가 준 확률을 그대로 넣으면 그게 증류입니다. 0.45처럼 애매하다고 한 영상은 애매하게, 0.95는 확실하게 배웁니다.
1
2
3
4
5
p = teacher["post_worthy"]          # 예: 0.7
gold = {
    "post_worthy": {"probabilities": {"true": p, "false": 1 - p}},   # 교사 확률 = 학습 목표
    "kind": {"probabilities": {k: (1.0 if k == teacher["kind"] else 0.0) for k in KINDS}},
}
시험용 40개를 뺀 384개로 학습했습니다. 학습 스크립트는 공식 Apple Silicon용 스크립트를 로컬 JSONL을 읽도록 고친 버전입니다(지난 글과 같음).
5. 시험 문제 40개
실제로 포스트를 쓴 영상 5개에 무작위 35개(국내 18, 해외 17)를 섞었습니다. 시험 정답은 교사와 별개로 다시 판정했습니다. 기준은 “실무에 바로 적용할 수 있는가”이고, 교사의 답을 보지 않고 매겼습니다. 두 판정은 40개 중 38개(95%)가 일치했고, 다른 2개는 교사 확률이 0.45로 경계선에 걸린 경우였습니다.
솔직히 짚어 둘 점: 시험 정답도 AI가 매겼습니다. 그래서 아래 수치는 “사람 기준 정확도”가 아니라 “AI 판단과의 일치도”에 가깝습니다. 사람 기준으로 검증된 건 실제로 포스트를 쓴 영상 5개의 순위뿐이라, 그 지표를 따로 봤습니다.
결과
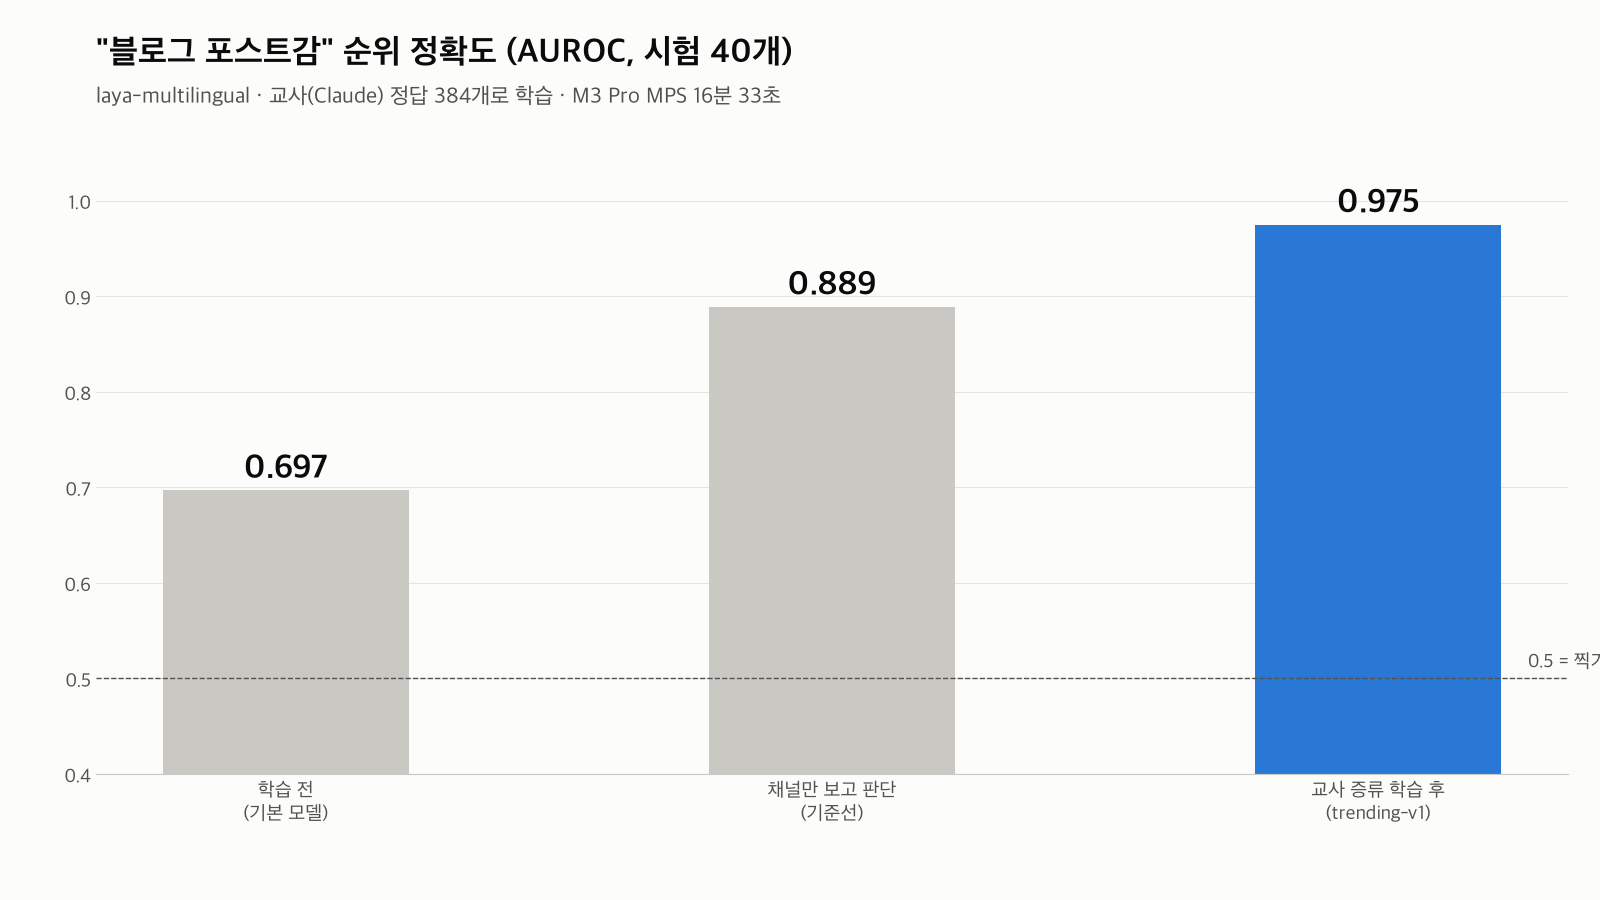
| 지표 (시험 40개) | 학습 전 | 학습 후 |
|---|---|---|
| 정답률 (기준값 0.5) | 15/40 | 33/40 |
| AUROC (1.0 완벽, 0.5 찍기) | 0.697 | 0.975 |
| 상위 10개 중 정답 | 4/10 | 8/10 |
| 유형(kind)이 교사와 일치 | 7/40 | 27/40 |
| 1건 처리 시간 | 63ms | 62ms |
학습은 M3 Pro MacBook(MPS)에서 16분 33초 걸렸습니다. 학습 전 모델은 거의 모든 영상에 “포스트감 1.00”을 줬습니다. 뉴스 모음에도, 해킹 사건 이야기에도요. 학습 후에는 실습형 영상만 위로 올라옵니다.
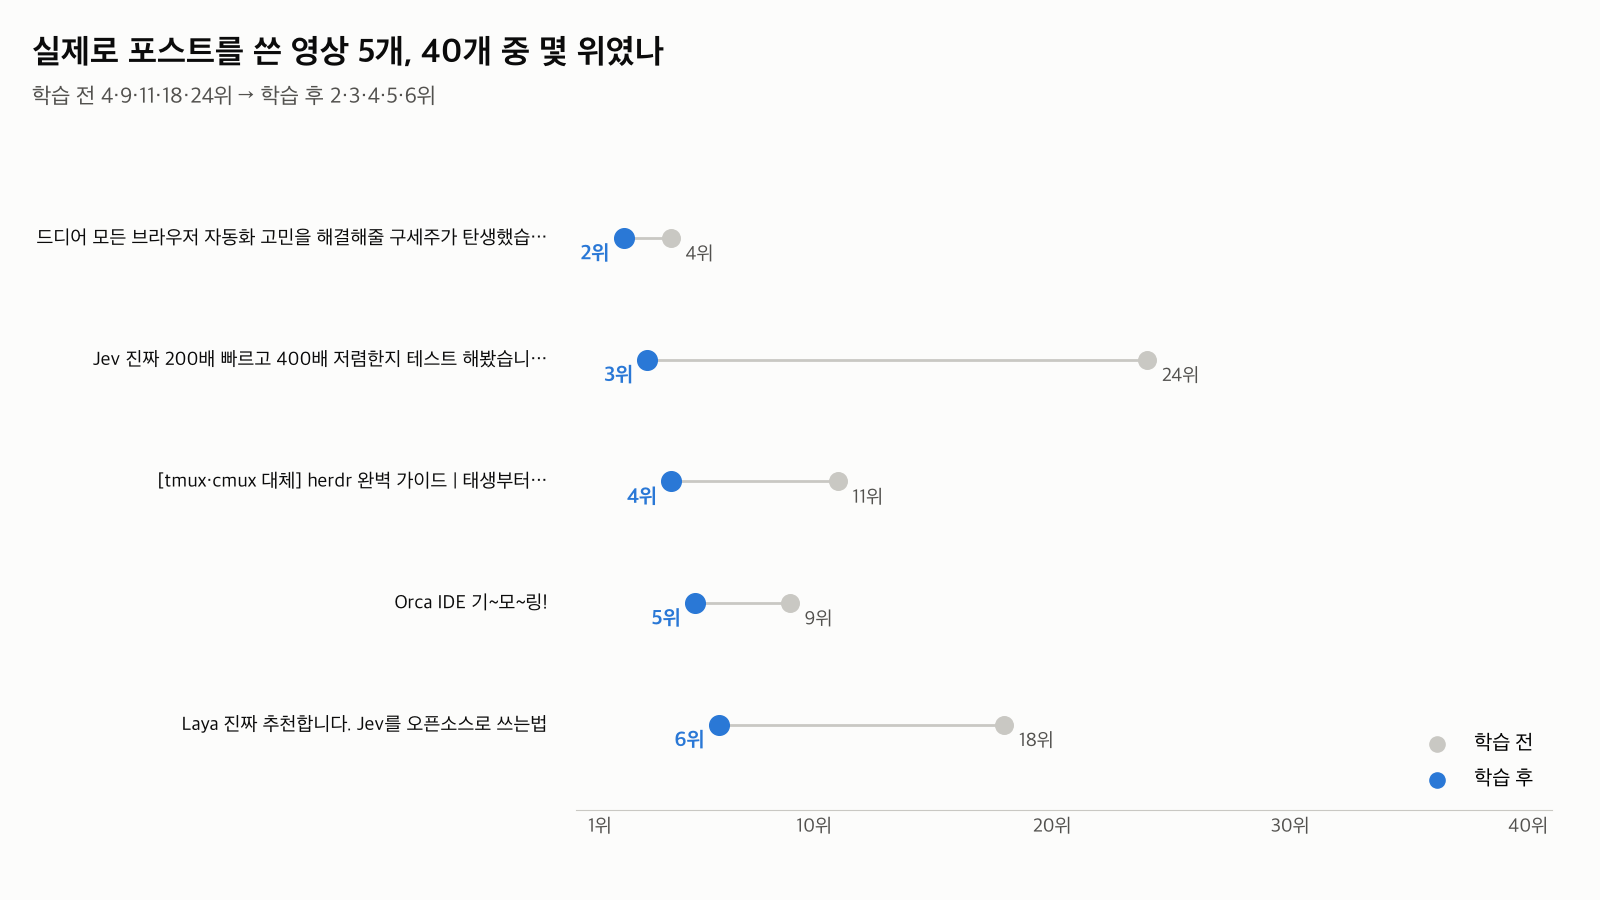
가장 의미 있는 결과는 이겁니다. 실제로 제가 포스트를 쓴 영상 5개가 모두 6위 안에 들어왔습니다. 학습 전에 24위였던 “Jev 진짜 200배 빠르고 400배 저렴한지 테스트”가 3위가 됐습니다.
채널 이름만 외운 건 아닐까?
교사 결과를 보면 코드팩토리는 55%가 포스트감이고 Latent Space는 0%입니다. 그러면 Laya가 영상 내용이 아니라 “어느 채널인가”만 외웠을 수도 있습니다. 그래서 두 가지를 확인했습니다.
- 채널만 보고 판단하는 기준선: 학습 데이터에서 채널별 포스트감 비율을 계산해 그대로 점수로 쓰면 AUROC 0.889입니다. Laya(0.975)가 그보다 높습니다.
- 같은 채널 안에서 비교: 시험에 들어간 코드팩토리 영상 8개끼리만 비교하면 AUROC 0.917입니다. 같은 채널 안에서도 “Grok 4.7 출시!” 같은 뉴스는 낮게, “Orca IDE” 같은 리뷰는 높게 매깁니다. 다만 나중에 다시 분석해 보니 학습 전 모델도 이 8개에서는 1.000이었습니다. 8개 중 “아님”이 2개뿐이라 이 비교는 근거가 약합니다. 채널 암기가 아니라는 근거는 1번(채널 기준선 0.889 → 0.975)으로 보는 게 맞습니다. (2026-10-06 추가)
실제로 1위는 해외 채널인 Matthew Berman의 “You NEED to try these 12 open-source AI projects”였습니다. 국내 실습 채널만 좋아하게 된 것도 아닙니다.
아쉬운 점: 확률이 납작해졌다
학습 후 확률이 0.2~0.6 사이에 몰렸습니다. 그래서 기준값 0.5로 자르면 놓치는 영상이 생깁니다(정답률 33/40에 그친 이유). 반대로 순위는 아주 정확합니다(AUROC 0.975). 영상 2에서 “학습하면 확신도 보정이 나빠진다”고 한 것과 같은 현상입니다. 그래서 실제 운영은 “0.5 이상”이 아니라 “상위 5개”로 쓰기로 했습니다.
실제 운영: 주간 리포트에 붙이기
블로그 트렌딩 스크립트(youtube_trending.py)에 Laya 섹션을 붙였습니다. 매주 리포트를 만들 때 화이트리스트 채널의 최근 7일 업로드를 학습한 Laya로 순위 매겨, 상위 5개를 리포트 끝에 덧붙입니다.
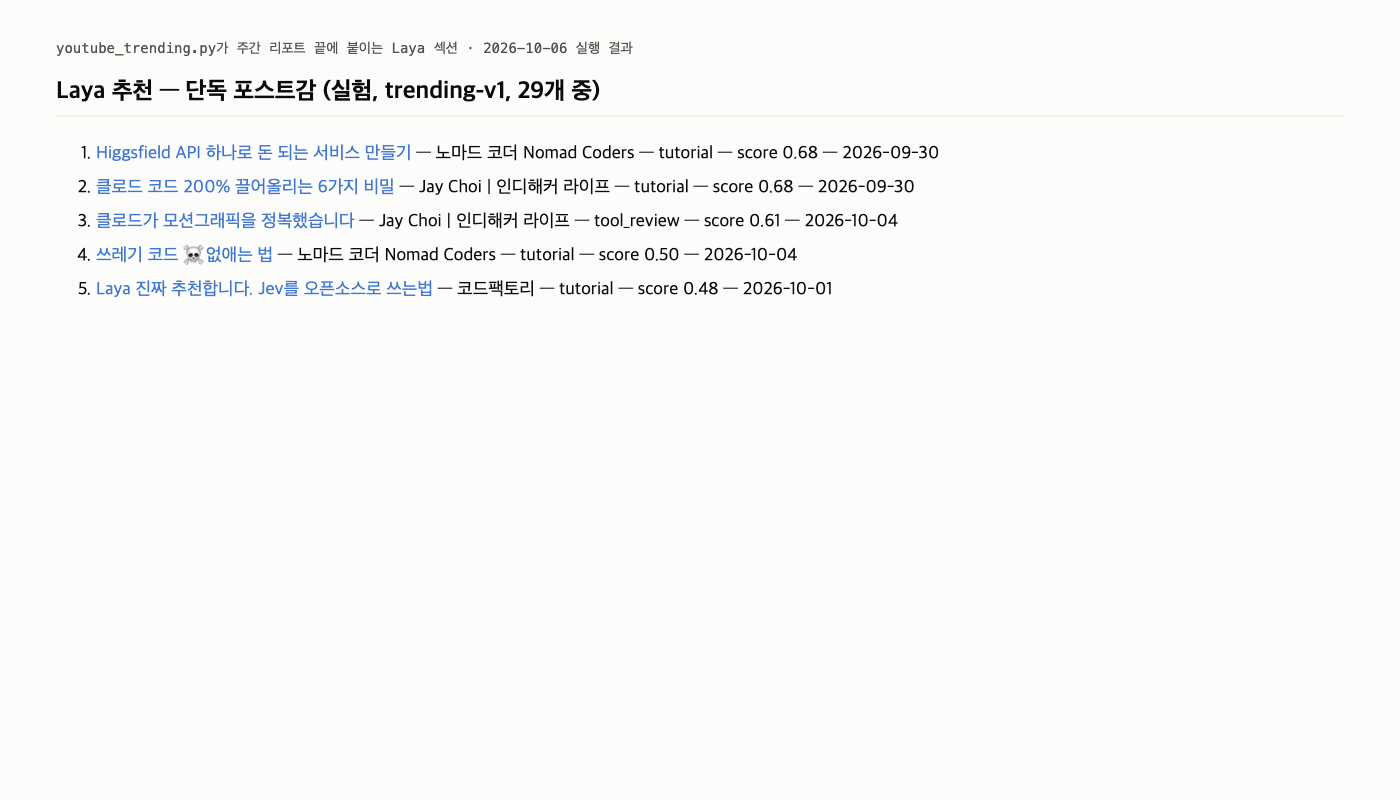
- 29개를 순위 매기는 데 약 14초, API는 약 15 units
- Laya 환경이 없거나 실패하면 섹션만 빠지고 리포트는 정상으로 만들어지게 했습니다
- 5위에 지난 글의 소재였던 “Laya 진짜 추천합니다”가 보입니다. 이미 쓴 글이지만, 기준에 맞는 영상을 제대로 골라낸다는 확인이기도 합니다
Laya 환경은 이번 기회에 한곳에 정리했습니다. 가상환경과 기본 모델은 하나만 두고, 작업별 학습 모델과 데이터만 따로 두는 구조입니다.
1
2
3
4
5
6
laya-lab/
├── .venv/              공용 Python 환경 (laya, torch)
├── models/base/        기본 다국어 모델 (647MB)
├── models/trending-v1/ 이번 학습 모델 (1.3GB)
├── shared/ft_mps.py    학습 스크립트
└── tasks/trending/     수집·교사 라벨·학습 데이터·평가·추천 스크립트
정리
| 질문 | 이번 실험의 답 |
|---|---|
| 사람 없이 Laya를 가르칠 수 있나? | 됩니다. 교사(Claude)의 확률을 그대로 목표로 넣어 AUROC 0.697 → 0.975 |
| 교사가 틀리면? | 그대로 배웁니다. 그래서 교사 판단 기준을 글로 명확히 적는 게 중요하고, 시험 문제는 따로 판정해야 합니다 |
| 데이터는 얼마나? | 384개, 학습 16분. 대신 다양한 실제 데이터였습니다 |
| 바로 쓸 수 있나? | 기준값보다 순위로 쓰면 됩니다. 학습 후 확률이 납작해집니다 |
| 민감한 데이터에도? | 외부 AI 교사는 안 됩니다. 사용 기록이나 로컬 교사를 써야 합니다 |
남은 과제는 운영 기록입니다. 몇 주 동안 추천을 받아 보고, 실제로 포스트를 쓴 영상이 추천 상위에 있었는지 쌓이면, 그 기록을 사람 정답으로 추가해 다음 버전을 학습할 계획입니다. 교사 증류로 시작해서 사용 기록으로 다듬는 순서입니다.
참고 자료
- Tonbi’s AI Garage — Laya: Fine-tuning the Open Jev-style Decision Model on Skill Routing (YouTube)
- AI WITH Rithesh — Laya Is INSANE… Open-Source AI Just Challenged Jev! (YouTube)
- Laya GitHub 저장소
- Laya 모델 카드 (Hugging Face)
- Jev vs Laya 비교 글 (anth.us)
// reading compass
이 글과 이어지는 경로
시리즈, 카테고리, 태그 겹침, 최신도를 점수화해 가까운 글일수록 중심에 배치합니다.
댓글남기기