Jev 대신 Laya? 노트북에서 학습시킨 오픈소스 판단 모델 [5/5]
SERIES TypeSafe Jev 완전 정복 5 / 5
- 1 전세계가 주목하는 AI 'Jev', 5분이면 이해합니다 — TypeSafe Jev 입문 [1/5]
- 2 Jev, 진짜 8배 빠르고 76배 저렴할까? 직접 테스트해봤다 [2/5]
- 3 Jev 모델 파헤치기: 구조, 원리, 그리고 활용법 [3/5]
- 4 Jev로 하루 업무 자동화하기: 실전 워크플로우 4가지 [4/5]
- ▶ Jev 대신 Laya? 노트북에서 학습시킨 오픈소스 판단 모델 [5/5]
입문부터 실전 자동화까지 네 편에 걸쳐 TypeSafe의 Jev를 다뤘습니다. 이번 편은 그 대안으로 떠오른 오픈소스 모델 Laya입니다. 유튜브 채널 코드팩토리의 “Laya 진짜 추천합니다. Jev를 오픈소스로 쓰는법” 영상 내용을 정리하고, 같은 실험을 제 MacBook에서 직접 작게 재현해 봤습니다.
한 줄 요약
- Laya는 Jev처럼 “정해진 선택지 중 하나를 고르는” 판단 전용 모델인데, 오픈소스(Apache 2.0)라 내 컴퓨터에서 돌리고 내 데이터로 학습시킬 수 있습니다.
- 영상에서는 M4 Pro MacBook으로 한국어 CS 분류를 학습시켜 32.8% → 86.4%(1,000건, 48분) → 99.7%(10,000건, 7시간 52분)까지 올렸습니다. Jev는 학습 없이 100%였습니다.
- 제가 직접 해 본 결과는 70.8% → 93.8%(100건, 75초)였고, 템플릿으로 찍어낸 데이터를 늘리자 오히려 85.4%까지 떨어졌습니다. 양보다 데이터의 다양성이 먼저라는 걸 확인했습니다.
Laya가 뭔가
Laya는 Convai Innovations가 2026년 9월 18일 공개한 비자기회귀(non-autoregressive) 판단 모델입니다. Jev 시리즈 1편에서 설명한 “System One” 개념을 그대로 따릅니다. 글을 한 글자씩 생성하는 대신, 상태(문의 내용, 이메일, JSON)와 질문을 한 번에 읽고 선택지별 확률을 내놓습니다. 텍스트를 생성하지 않으니 파싱할 것도, 환각할 것도 없습니다.
| 항목 | 내용 |
|---|---|
| 만든 곳 | Convai Innovations (GitHub NandhaKishorM/laya) |
| 라이선스 | Apache 2.0 (상업 사용 가능) |
| 질문 유형 | choice(선택지 고르기), score(등급), noul(예/아니오 확률) |
| 체크포인트 | laya(영어, 약 421M), laya-multilingual(100개 이상 언어, mmBERT 기반 322M), laya-typed-decisions(파인튜닝판) |
| 속도 | T4 GPU 기준 질문 1개 33ms, 배치 시 질문당 7.2ms (공식 수치) |
| 설치 | pip install laya |
체크포인트가 셋인 이유는 Router 때문입니다. 입력 텍스트의 문자 체계와 언어를 1ms 안쪽으로 감지해서, 한국어처럼 영어가 아닌 입력은 자동으로 laya-multilingual로 보냅니다.
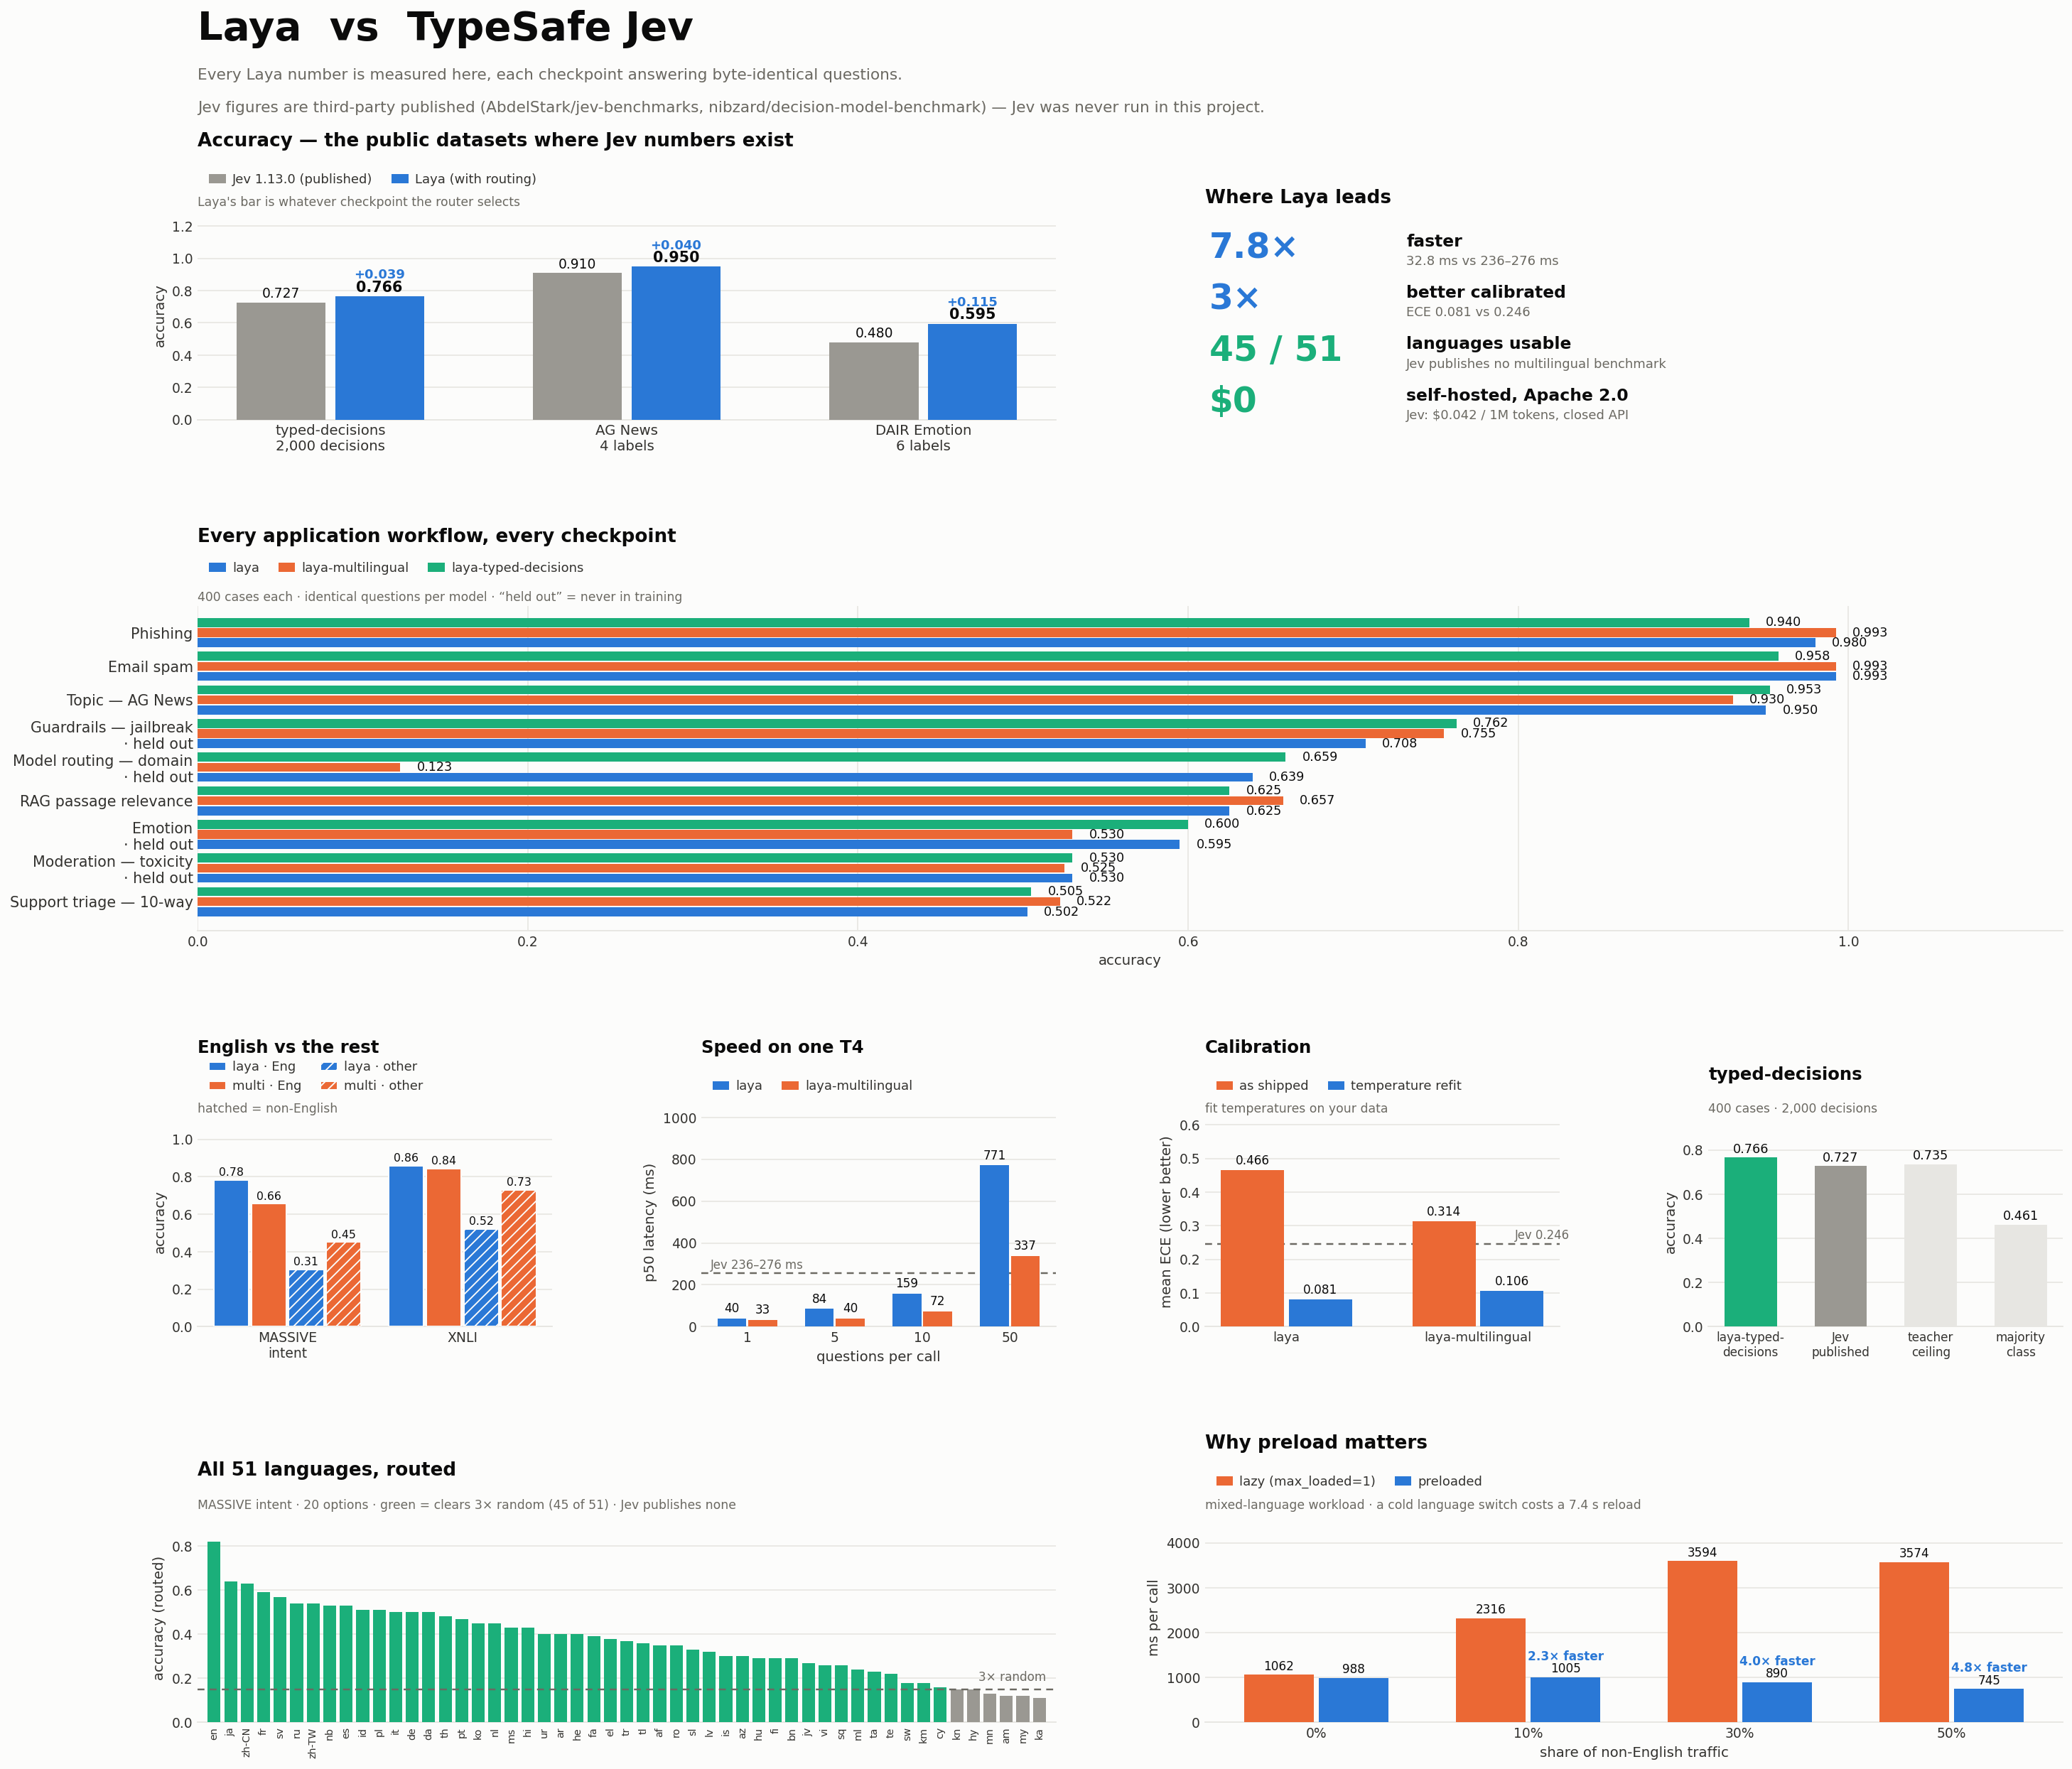
공식 저장소는 위 차트로 “Jev보다 7.8배 빠르고 정확도도 앞선다”고 주장합니다. 다만 차트 상단에 적혀 있듯 Jev 수치는 제3자가 공개한 벤치마크를 가져온 것이고, Laya 프로젝트에서 Jev를 직접 돌린 적은 없습니다. 같은 README에서 “기본 체크포인트는 학습 없이 쓰면 무작위 수준(0.36)에 가깝다, Laya는 바로 쓰는 모델이 아니라 특화시키는 출발점으로 보라”고 스스로 밝히고 있다는 점도 함께 봐야 합니다.
왜 라우팅인가
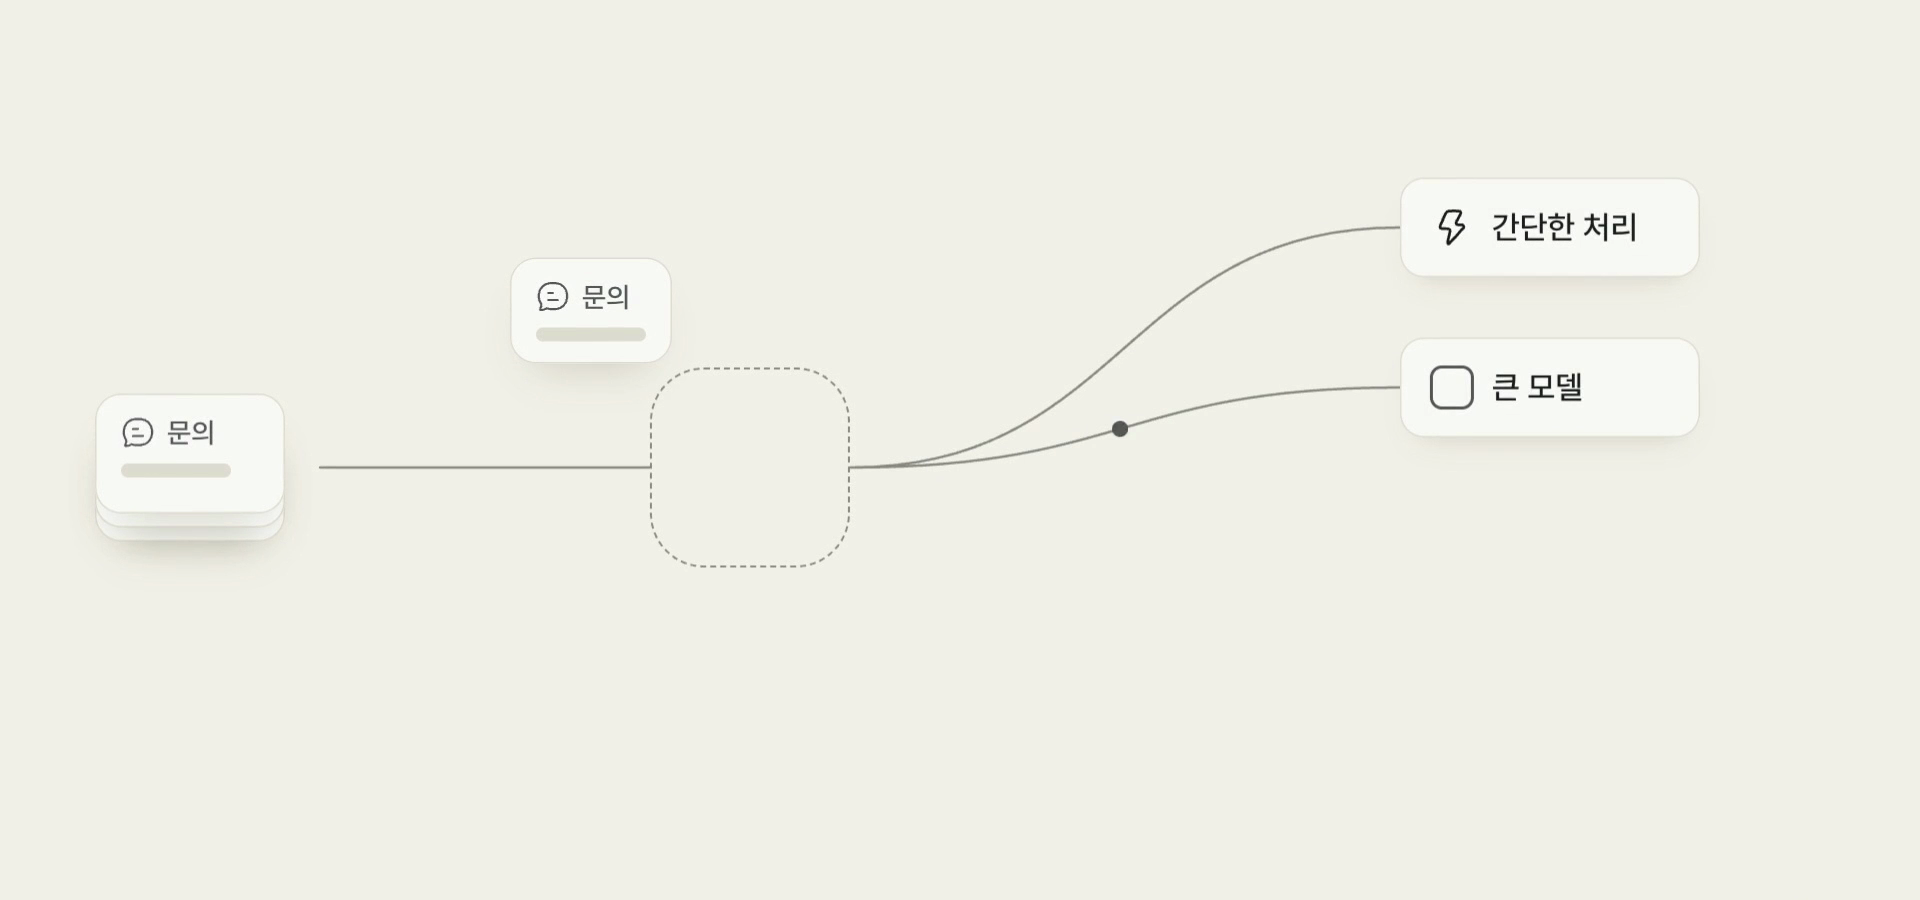
영상은 Jev 때와 같은 문제의식에서 출발합니다.
- 모든 요청을 가장 좋은 LLM으로 보내면 구현은 쉽지만 API 비용과 대기 시간이 폭증합니다.
- 반대로 전부 싸고 빠른 모델에 맡기면 복잡한 요청의 답변 품질이 떨어집니다.
- 그래서 앞단에서 요청을 먼저 분류합니다. 간단히 처리할지, 강한 모델이 필요한지, 사람이 봐야 하는지, 답할 필요가 없는지.
CS(고객 상담)가 라우팅에 특히 잘 맞는 이유도 짚습니다. 문의량이 많고, 문의마다 해야 할 일이 완전히 다르기 때문입니다. 영상의 예시가 핵심을 잘 보여 줍니다.
“배송이 늦어요”와 “배송이 늦으니 주문 취소해 주세요”는 둘 다 ‘배송’을 말하지만, 두 번째 고객은 취소를 원합니다.
키워드만 보면 같은 문의인데 처리 경로는 다릅니다. 여기서 잘못 보내면 뒤에서 아무리 답변을 잘 만들어도 고객은 원하는 결과를 못 얻습니다. 그래서 빠르고 싸면서도 의도를 정확히 읽는 앞단 모델이 필요하고, 그 자리를 Jev 또는 Laya가 맡습니다.
영상의 실험: MacBook에서 Laya 학습시키기
실험 설계
- 과제: 한국어 쇼핑몰 문의를 배송·취소·교환·반품 등 6개 범주로 분류
- 데이터: 실제로 들어올 법한 문의와 정답을 짝지은 합성 데이터
- 시험: 학습 데이터와 따로 떼어 둔 250문제를 고정(frozen test)해 두고 모든 단계를 같은 시험으로 비교
- 학습 방식: 100건, 300건, 1,000건을 각각 같은 기본 모델에서 새로 학습 (이어서 학습한 게 아님)
결과: 데이터를 늘릴수록 오르지만, 오르는 폭은 줄어든다
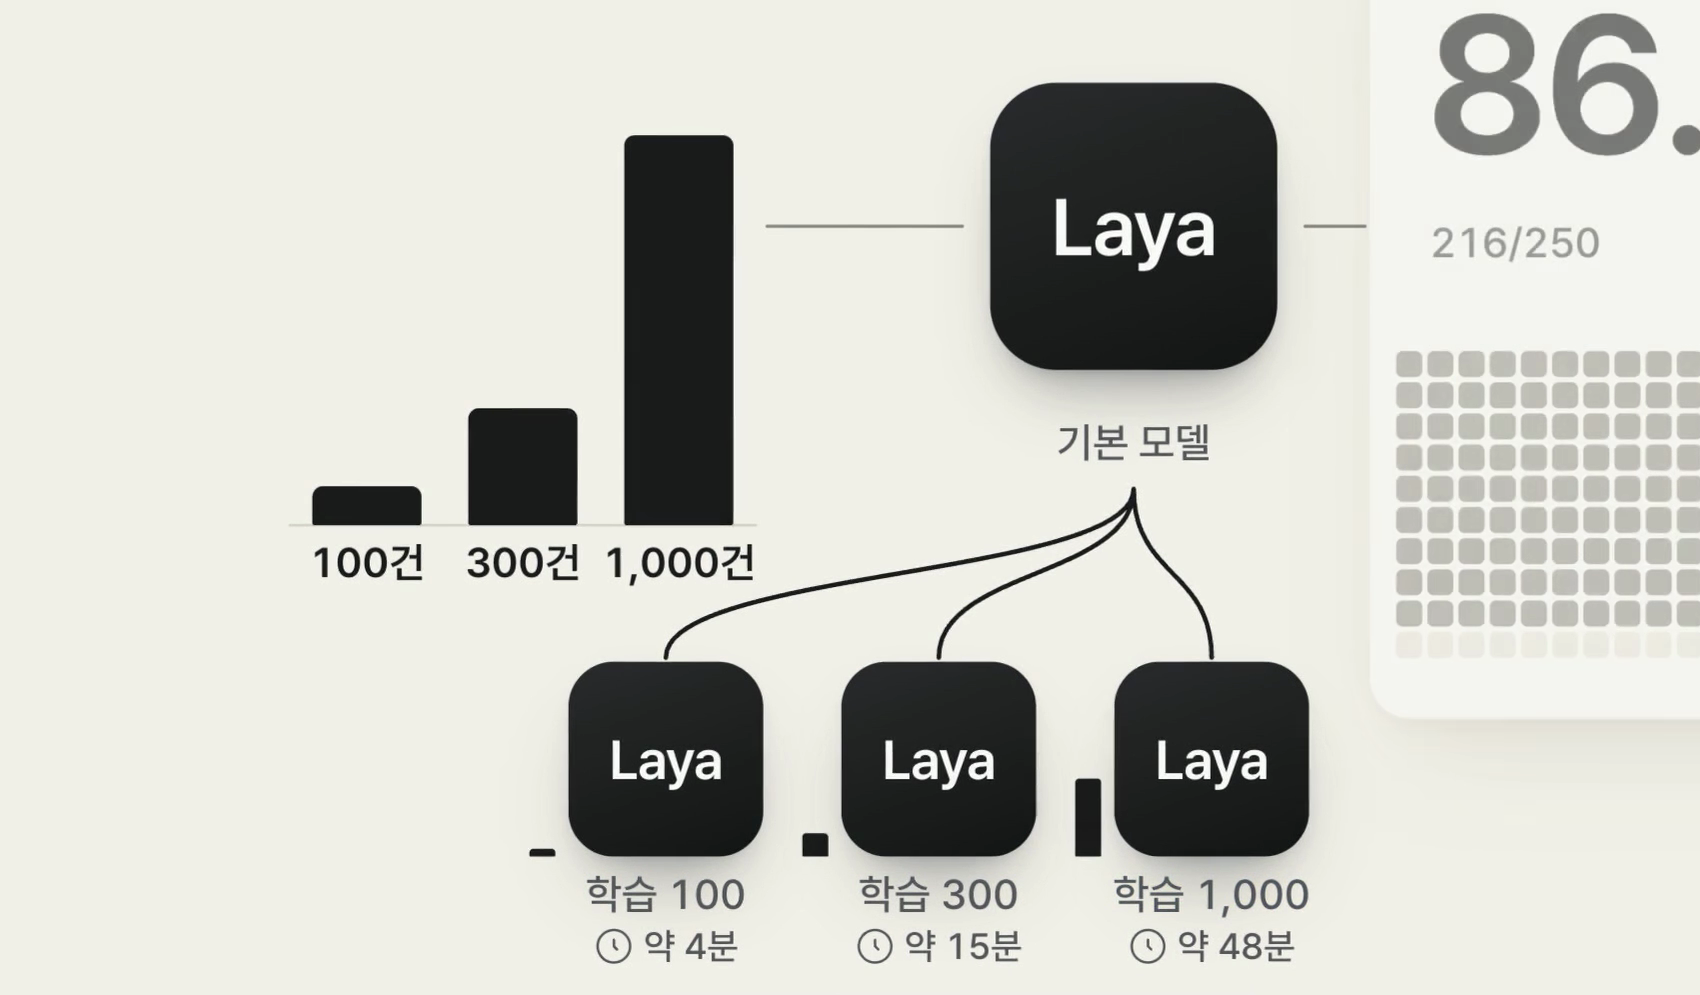
| 학습 데이터 | 학습 시간 | 정확도 (250문제) |
|---|---|---|
| 학습 전 | - | 32.8% (82개) |
| 100건 | 약 4분 | 68.8% (172개) |
| 300건 | 약 15분 | 83.2% |
| 1,000건 | 약 48분 | 86.4% (216개) |
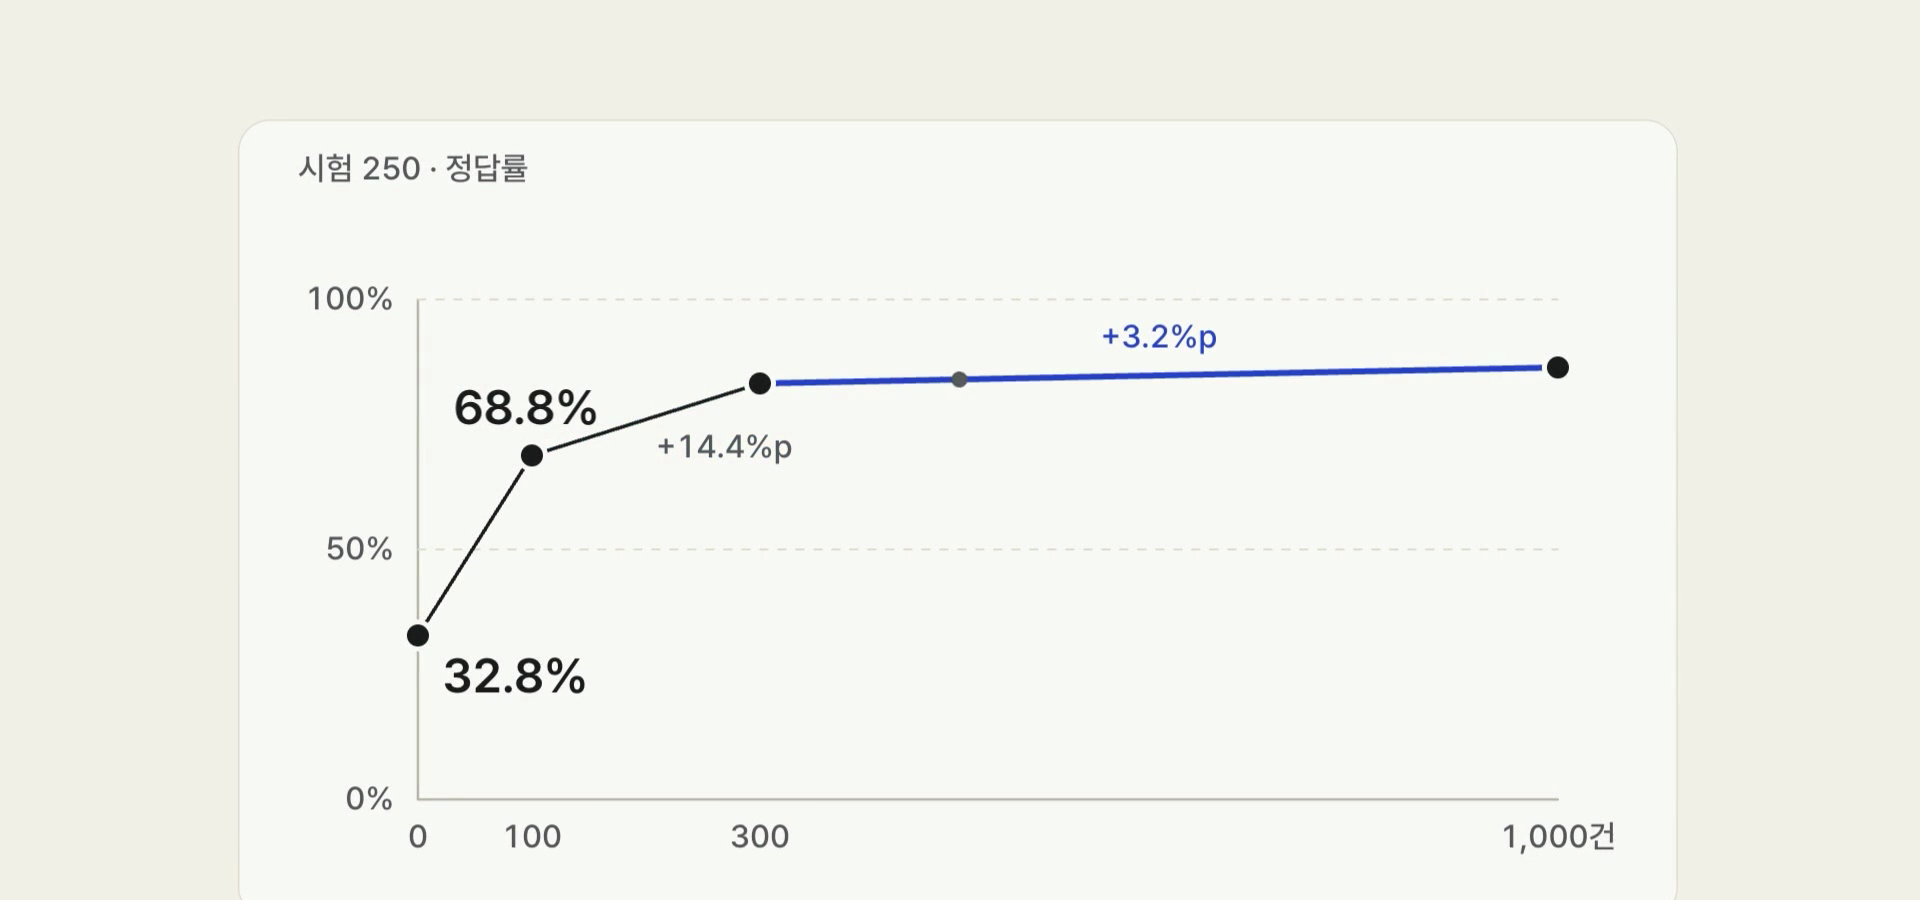
학습 전에는 세 문제 중 하나만 맞히던 모델이 100건, 4분 학습만으로 90문제를 더 맞혔습니다. 반면 300건에서 1,000건으로 세 배 넘게 늘렸을 때는 83.2%에서 86.4%로 3.2%p밖에 안 올랐습니다.
같은 시험을 Jev에게 풀게 하면
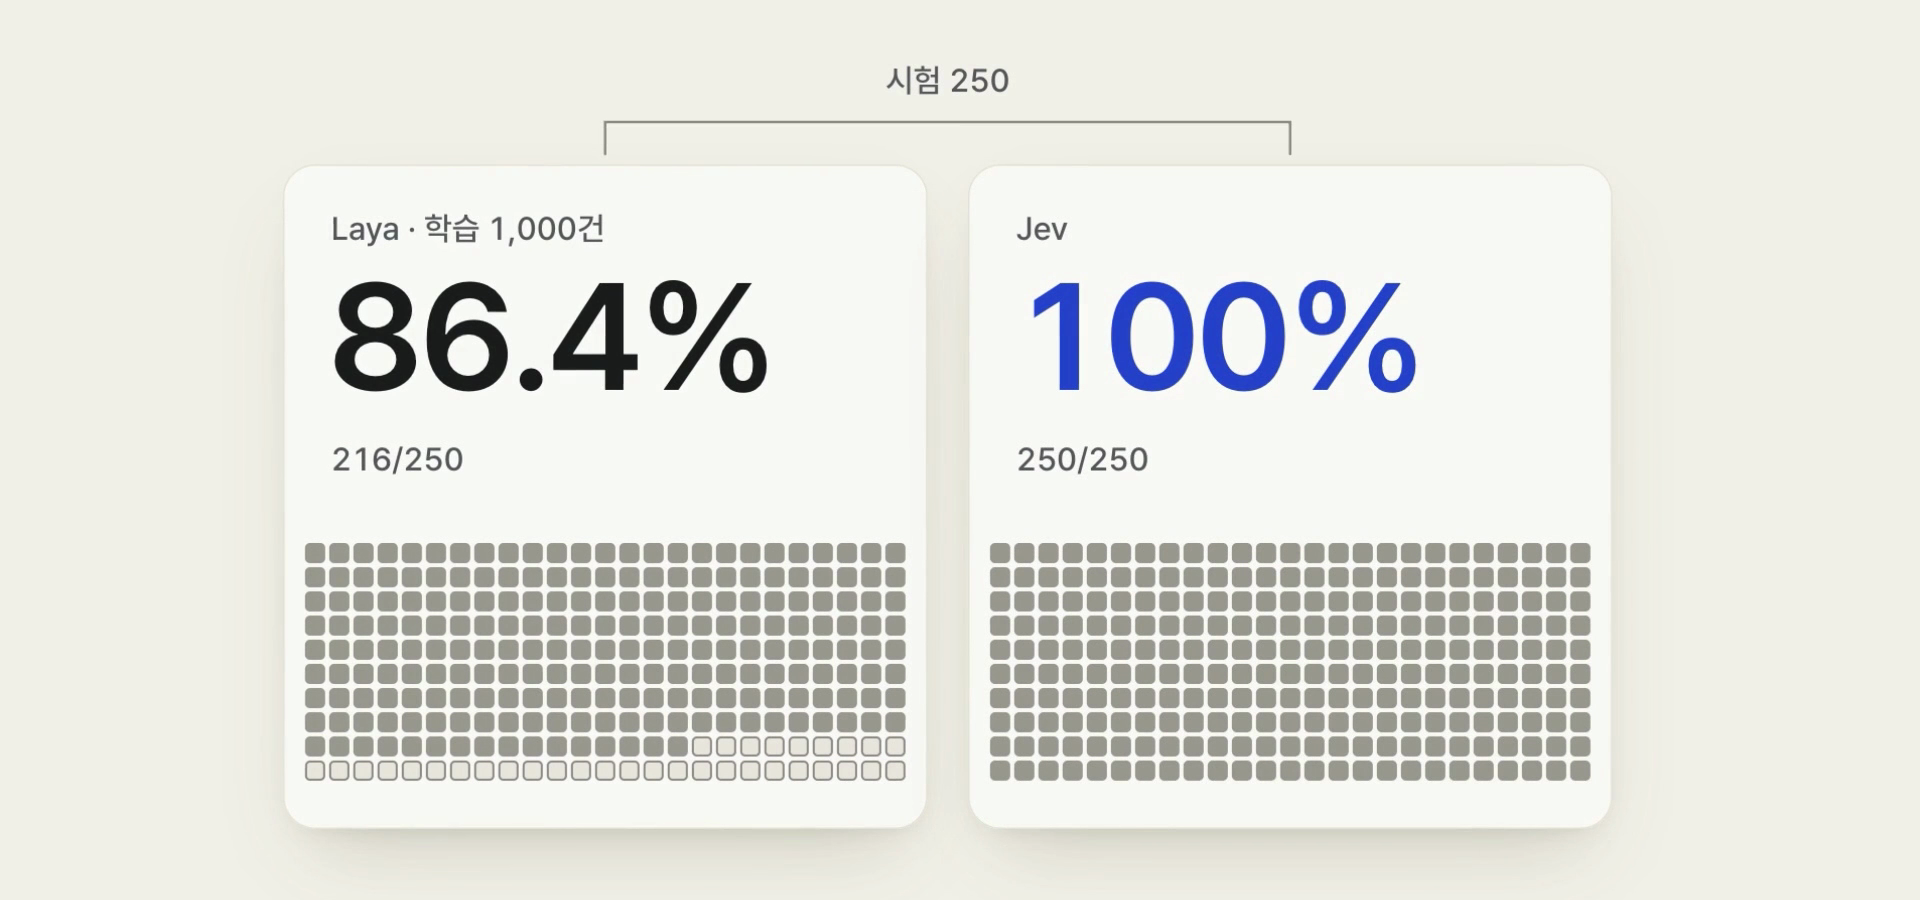
Jev는 학습 없이 250문제를 전부 맞혔습니다. 발표자도 “잘할 거라 생각했지만 하나도 안 틀릴 줄은 몰랐다”고 할 만큼 범용 성능 차이가 분명했습니다.
10,000건까지 밀어붙이기
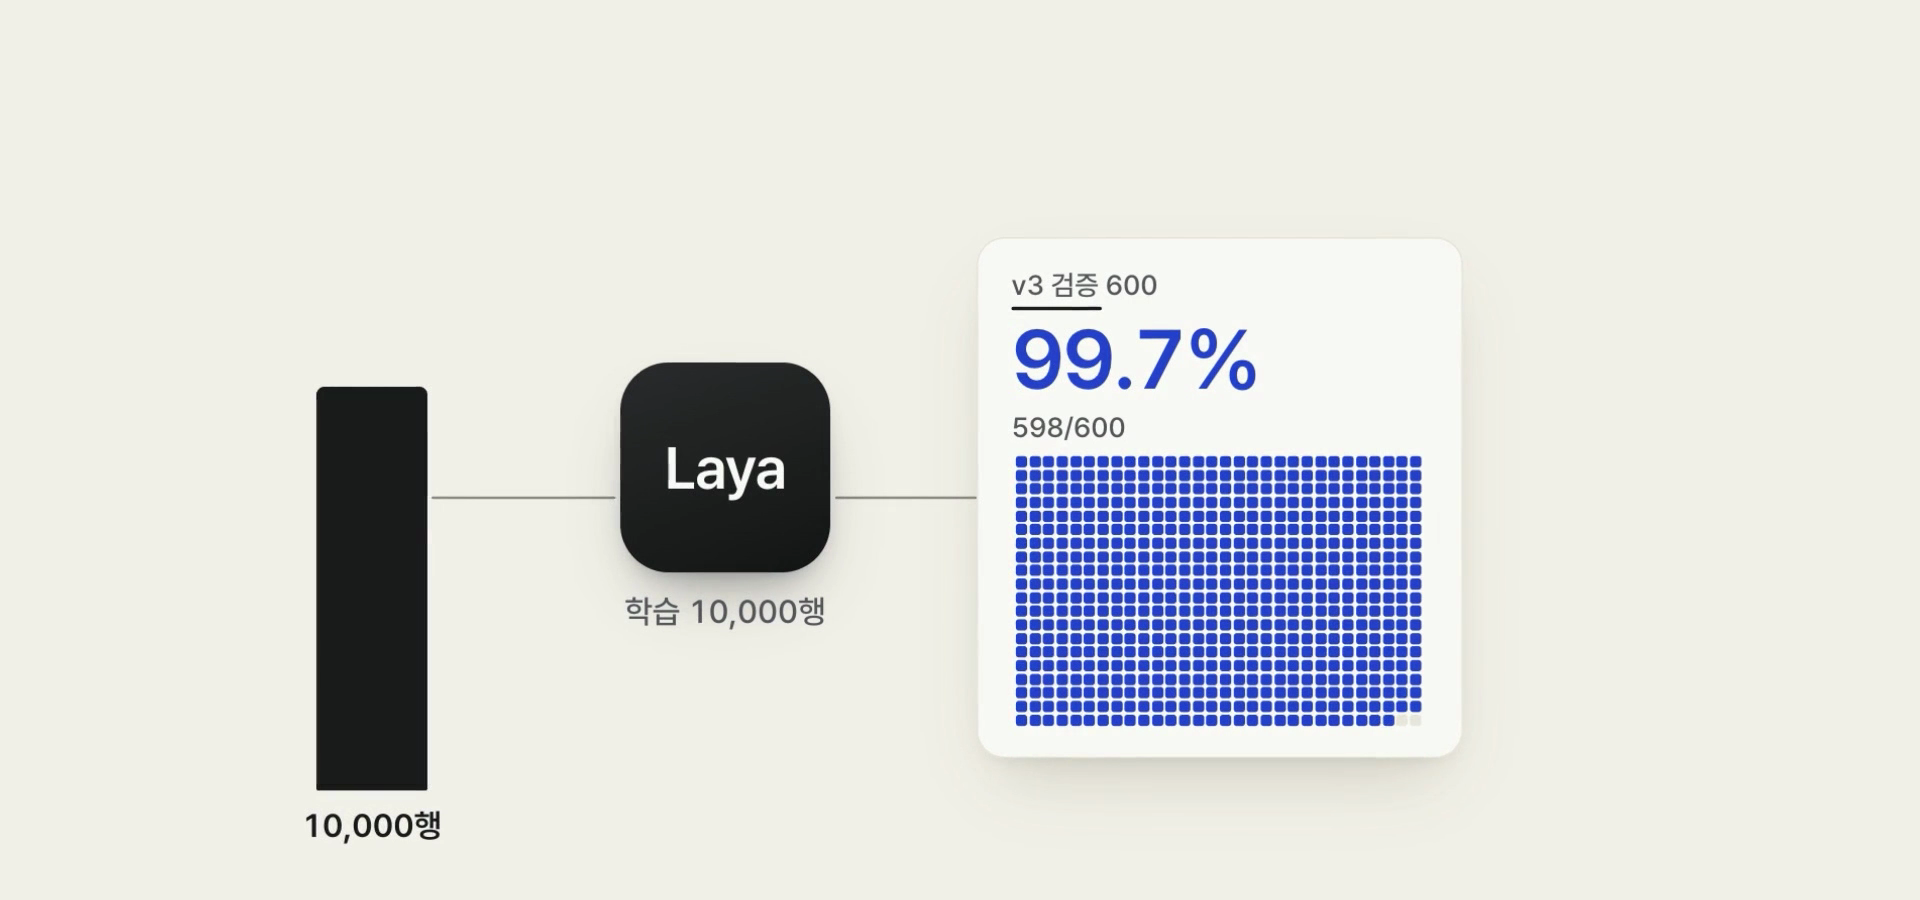
그래서 데이터를 10,000건으로 늘렸습니다. 같은 MacBook에서 7시간 52분 학습했고, 새로 만든 600문제 검증에서 학습 전 35.8%였던 정확도가 99.7%(598/600)까지 올랐습니다. 특정 도메인 하나에서는 Jev에 거의 근접한 셈입니다. 물론 Jev는 범용 모델이라 다른 분야도 학습 없이 잘하므로, “Laya가 Jev를 따라잡았다”가 아니라 “원하는 도메인에 맞춰 학습시키면 매우 높은 정확도까지 갈 수 있다”가 정확한 결론입니다.
틀린 문제로 다시 가르치기
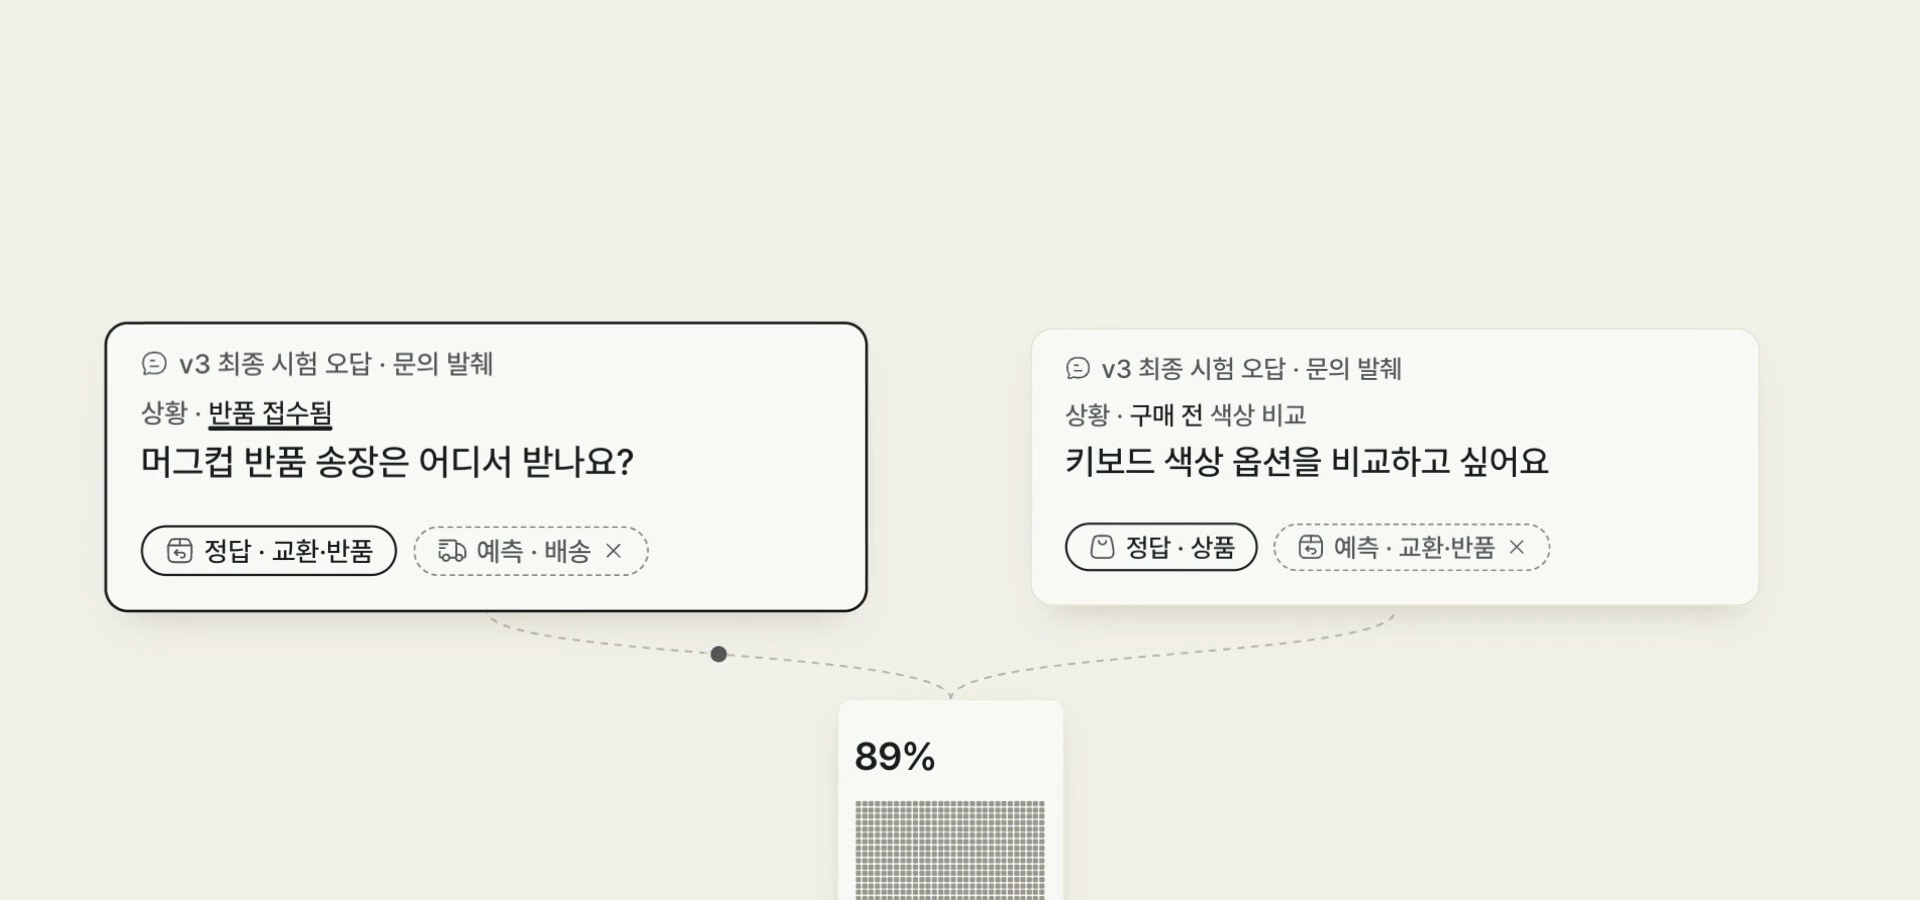
영상에서 가장 실무적인 부분입니다. Laya가 틀린 문제를 보면 두 종류였습니다.
- 이해할 만한 실수: “머그컵 반품 신청서는 어디서 받나요?” (반품 접수 이미 함) → 교환/반품이어야 하는데 배송으로 분류
- 황당한 실수: “키보드 색상 옵션을 비교해 보고 싶어요” (구매 전) → 상품 문의여야 하는데 교환/반품으로 분류
발표자가 제안하는 개선 방법은 이렇습니다. 틀린 답을 고치는 데서 그치지 말고, 헷갈리는 사례를 짝지어 모읍니다. “구매 전 색상 비교”와 “받은 상품을 다른 색으로 교환”을 나란히 놓고, 무엇이 분류를 가르는지 학습시킨 뒤 학습에 쓰지 않은 새 문의로 다시 시험합니다. 오픈소스라서 이렇게 우리 업무 기준에 맞춰 계속 고쳐 나갈 수 있다는 게 Laya의 진짜 장점입니다.
속도: 로컬이라 빠르다
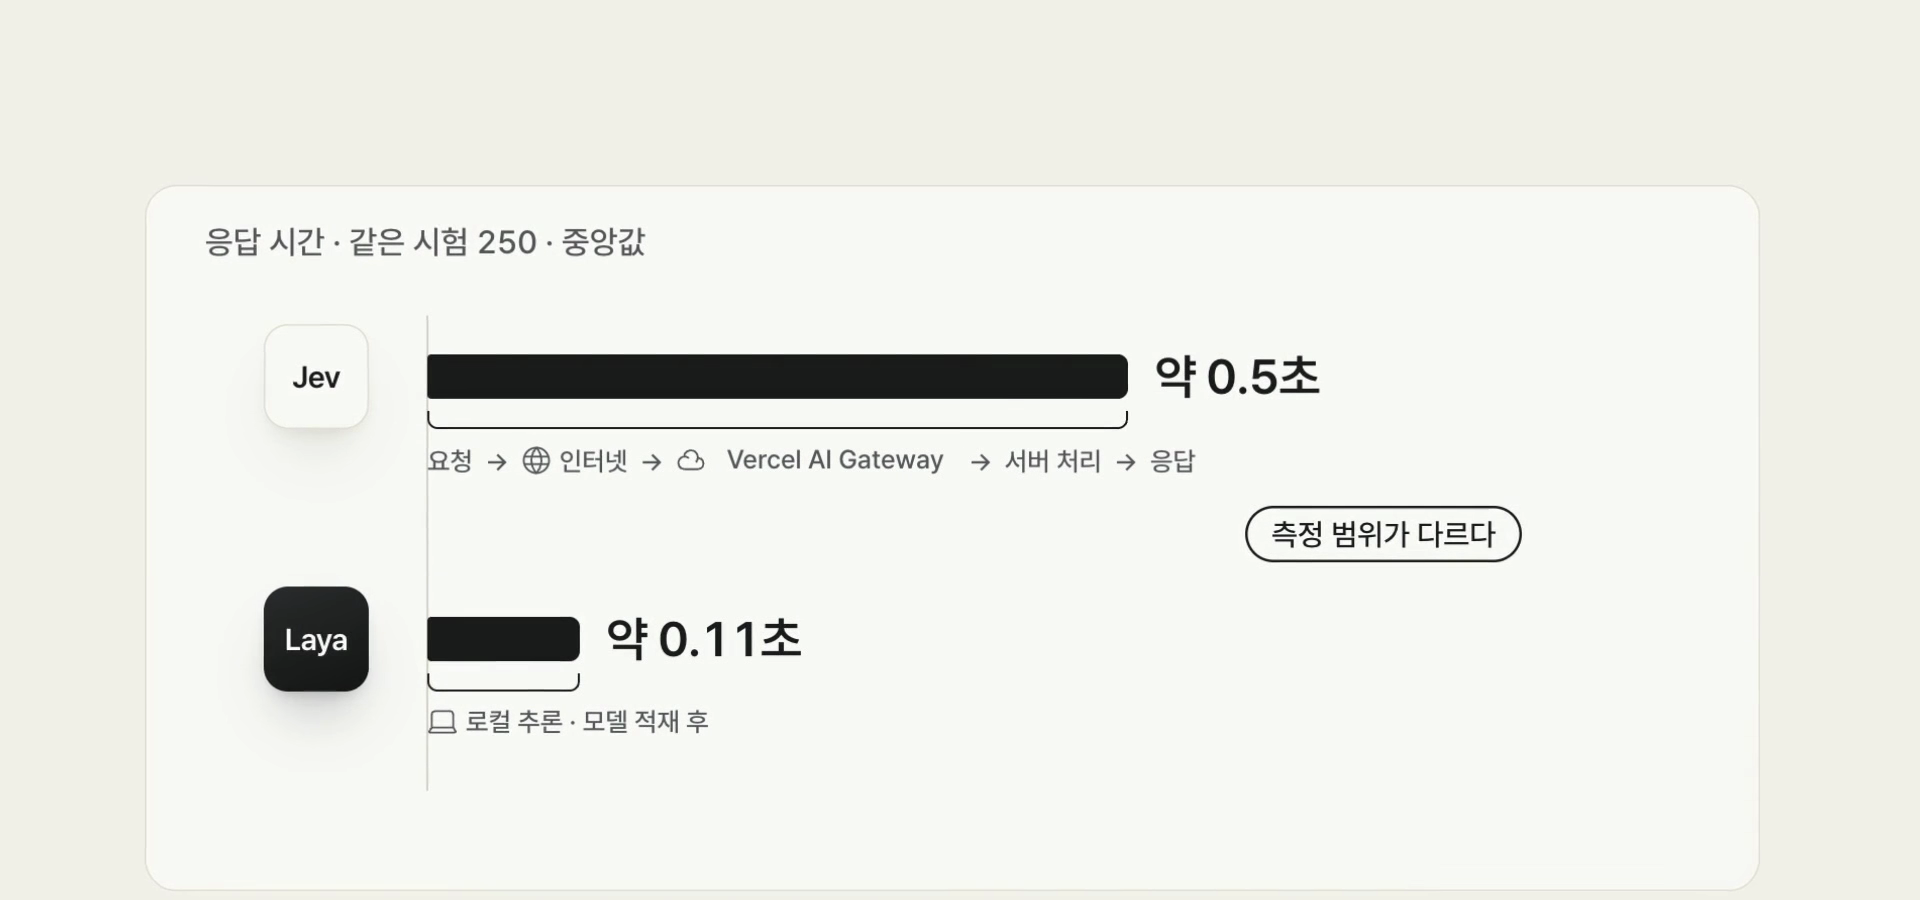
라우팅은 답변 생성 전에 반드시 거치는 단계라서, 여기가 느리면 전체 응답이 그만큼 늦어집니다.
- Jev API: 중앙값 약 0.5초 (Vercel AI Gateway 경유)
- Laya(로컬): 1건당 약 0.11초
단, 이건 Jev 모델이 느리다는 뜻이 아닙니다. Jev 시간에는 인터넷 왕복과 서버 처리가 포함되고, Laya는 같은 컴퓨터에서 돌린 시간입니다. 오히려 중요한 건 고객 문의를 외부 서버로 보내지 않고 사내에서 분류할 수 있다는 점입니다. 민감한 회사 데이터를 다룬다면 이 차이가 훨씬 큽니다.
직접 해 봤다: M3 Pro에서 작게 재현
영상 수치만 옮기기보다 직접 돌려 보는 게 낫겠다 싶어 작은 규모로 같은 실험을 해 봤습니다.
환경과 데이터
| 항목 | 내용 |
|---|---|
| 장비 | MacBook Pro M3 Pro, 메모리 36GB, PyTorch MPS |
| 버전 | laya 0.3.23, torch 2.14.1, 체크포인트 laya-multilingual |
| 범주 | 배송 조회 / 주문 취소 / 교환·반품 / 환불·결제 / 상품 문의 / 상담원 연결 (6개) |
| 학습 데이터 | 템플릿 36개 × 상품명 14개로 만든 합성 문의 504건 |
| 시험 | 직접 손으로 쓴 48문제(범주당 8문제). 학습 템플릿과 표현을 일부러 다르게 쓰고, “배송 늦어서 그냥 취소하려고요” 같은 헷갈리는 문장을 섞음 |
분류 질문은 Laya의 choice 형식으로 이렇게 정의했습니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
QUESTION = {
    "route": {
        "type": "choice",
        "instructions": "이 고객 문의를 어느 처리 경로로 보내야 하나요?",
        "criteria": {
            "delivery": "배송 조회: 배송 위치, 도착 예정일, 송장 확인 (주문 취소 요청 없음)",
            "cancel": "주문 취소: 아직 받지 않은 주문을 취소하고 싶음",
            "exchange_return": "교환/반품: 이미 받은 상품을 교환하거나 반품하고 싶음",
            "refund_payment": "환불/결제: 결제 오류, 이중 결제, 환불 금액·입금 시점 문의",
            "product": "상품 문의: 구매 전 사이즈, 색상, 재고, 사양 질문",
            "human": "상담원 연결: 강한 불만, 분쟁, 보상 요구, 법적 대응 언급",
        },
    }
}
평가는 체크포인트를 불러 48문제를 하나씩 예측하고 시간을 쟀습니다.
1
2
3
4
5
import laya

agent = laya.load("convaiinnovations/laya-multilingual")  # 또는 학습한 폴더 경로
res = agent.predict("배송 늦어서 그냥 취소하려고요", QUESTION)
print(res["answers"]["route"]["choice"])  # cancel
학습은 공식 저장소의 Apple Silicon용 스크립트(notebooks/laya_finetune_typed_decisions_mps.py)를 썼습니다. 이 스크립트는 원래 공개 데이터셋(LocalLLaMA/typed-decisions)만 읽게 되어 있어서, 데이터 로딩 부분만 로컬 JSONL을 읽도록 고쳤습니다. 한 줄 형식은 {"state": 문의, "questions": QUESTION, "gold": {"route": {"probabilities": {정답: 1.0, 나머지: 0.0}}}}입니다.
1
2
3
python laya_finetune_typed_decisions_mps.py \
  --model-id convaiinnovations/laya-multilingual \
  --micro-batch 2 --grad-accum 8   # 기본 4 epoch, 데이터의 10%는 온도 보정용
결과
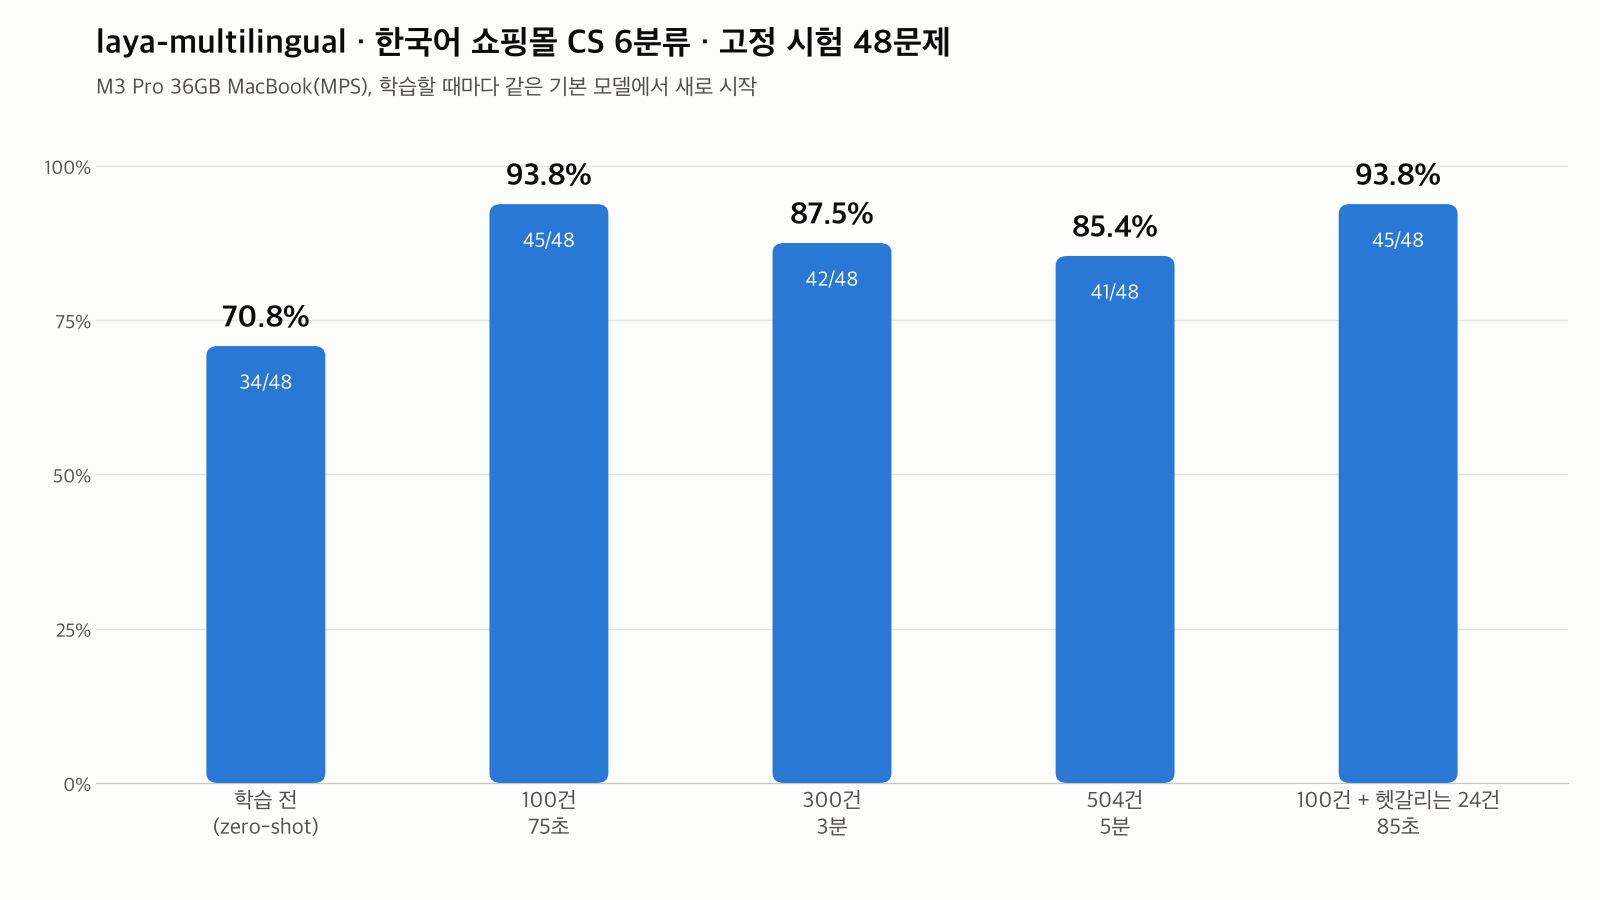
| 학습 데이터 | 학습 시간 | 정확도 (48문제) | 응답 시간 중앙값 |
|---|---|---|---|
| 학습 전 | - | 70.8% (34) | 26ms |
| 100건 | 75초 | 93.8% (45) | 26ms |
| 300건 | 3분 | 87.5% (42) | 26ms |
| 504건 | 5분 3초 | 85.4% (41) | 30ms |
| 100건 + 헷갈리는 사례 24건 | 85초 | 93.8% (45) | 26ms |
결과에서 읽은 것 4가지
1. 학습 전 점수가 영상보다 훨씬 높았다 (32.8% vs 70.8%) 시험이 달라서 직접 비교할 수는 없지만, 범주마다 “배송 조회: 배송 위치, 도착 예정일… (주문 취소 요청 없음)”처럼 판단 기준을 구체적으로 적어 준 영향이 큰 것으로 보입니다. 학습 전에 기준 문구부터 다듬는 게 가장 싼 개선입니다.
2. 100건, 75초 학습으로 93.8% 영상의 “적은 데이터로 크게 뛴다”가 그대로 재현됐습니다. 학습 시간은 영상(100건 약 4분)보다도 짧았습니다.
3. 데이터를 늘렸더니 오히려 떨어졌다 300건에서 87.5%, 504건에서 85.4%로 내려갔습니다. 원인은 데이터 구조로 보입니다. 템플릿 36개에 상품명만 바꿔 끼웠기 때문에 데이터를 늘려도 새로운 표현이 늘지 않고 같은 문장 패턴만 반복됩니다. 실제로 504건 모델은 틀린 문제 7개 중 5개에서 확신도 1.0을 냈습니다. 템플릿에 과적합된 신호입니다. 영상이 “데이터의 양과 품질에 따라 정확도가 달라진다”고 한 말을 반대 방향에서 확인한 셈입니다. 다만 시험이 48문제라 1문제가 2.1%p라는 점은 감안해야 합니다.
4. 헷갈리는 사례를 짝지어 넣으면 틀리는 방식이 바뀐다 영상의 제안대로 100건에 헷갈리는 사례 24건(예: “반품은 끝났고 환불 입금 시점 문의” → 환불, “구매 전 노트북 수납 칸 질문” → 상품 문의)을 더했습니다. 정확도는 93.8%로 같았지만 상품 문의는 8/8이 됐고, 틀린 답에 대한 확신도가 1.0에서 0.92 수준으로 내려갔습니다. 끝까지 틀린 두 문제가 흥미롭습니다.
| 문의 | 정답 | Laya 예측 |
|---|---|---|
| 반품 완료됐다는데 돈이 아직 안 들어왔어요 | 환불/결제 | 교환/반품 |
| 반품 거절 이유가 납득이 안 돼서 분쟁 조정 신청할 거예요 | 상담원 연결 | 교환/반품 |
둘 다 “반품”이라는 단어에 끌려가는 사례입니다. 영상의 “배송이 늦으니 취소” 예시와 똑같은 함정이고, 이런 문장은 짝지은 사례를 더 많이 모아서 계속 가르쳐야 합니다.
Jev vs Laya, 언제 무엇을 쓰나
| 기준 | Jev | Laya |
|---|---|---|
| 바로 쓸 때 정확도 | 높음 (영상 시험 100%) | 낮음, 학습이 사실상 필수 |
| 내 업무 기준에 맞추기 | 프롬프트와 선택지 설명으로만 조정 | 직접 학습, 틀린 사례로 계속 개선 |
| 응답 시간 | 약 0.5초 (네트워크 포함) | 약 0.03~0.11초 (로컬) |
| 비용 | 사용량 과금 API | 무료 (내 장비 비용만) |
| 데이터 반출 | 외부 API로 전송 | 사내에서 처리 가능 |
| 운영 부담 | 없음 | 모델 관리, 재학습, 배포를 직접 |
정리하면 이렇습니다.
- 빨리 붙여야 하고 범용 판단이 필요하면 Jev. 학습 데이터 없이 바로 높은 정확도가 나옵니다.
- 분류 기준이 우리 회사만의 것이고, 데이터를 밖으로 못 보내고, 호출량이 많아 비용이 걱정되면 Laya. 노트북 한 대로도 몇 분이면 쓸 만한 수준까지 올라갑니다.
- 둘을 섞는 것도 방법입니다. 초기에는 Jev로 라벨을 만들고, 그 결과로 Laya를 학습시켜 로컬로 옮기는 식입니다.
시작하기
가상환경에 설치하고 CLI로 바로 확인할 수 있습니다. 첫 실행 때 Hugging Face에서 체크포인트를 내려받습니다(다국어 체크포인트 약 650MB).
1
2
3
4
5
6
7
python -m venv .venv
.venv/bin/python -m pip install laya

# 미리 정의된 문의 분류 질문 세트로 바로 시험
.venv/bin/laya "결제가 두 번 됐어요" --preset triage
# Model  : multilingual  (hangul 감지 → 다국어 체크포인트)
# intent : refund (p=1.000)
코드 없이 써 보고 싶다면 저장소를 받아 pip install "laya[serve]" 후 python examples/server.py를 실행하면 http://127.0.0.1:8000에 웹 GUI와 JSON API가 뜹니다.
Python에서는 Router를 쓰면 언어에 맞는 체크포인트를 알아서 고릅니다.
1
2
3
4
5
6
from laya import Router

router = Router()
result = router.predict("배송 늦어서 그냥 취소하려고요", QUESTION)
print(result["routing"]["model"])               # multilingual
print(result["answers"]["route"]["choice"])     # cancel
마치며
Laya는 “Jev를 공짜로 대체하는 모델”이라기보다 “내 업무 기준을 직접 가르칠 수 있는 판단 모델”입니다. 학습 없이 쓰면 Jev에 한참 못 미치지만, 노트북에서 몇 분만 학습시켜도 실무에 쓸 만한 수준까지 올라옵니다. 직접 해 보니 핵심은 학습 시간이나 장비가 아니라 데이터를 어떻게 만드느냐였습니다. 같은 문장을 반복해서 늘린 데이터는 오히려 성능을 깎았고, 헷갈리는 사례를 짝지어 넣는 쪽이 모델이 틀리는 방식을 바꿨습니다.
Jev 시리즈는 여기까지입니다. 1편부터 다시 보고 싶다면 Jev 입문에서 시작하면 됩니다.
참고 자료
- 코드팩토리 — Laya 진짜 추천합니다. Jev를 오픈소스로 쓰는법 (YouTube)
- Laya GitHub 저장소 (NandhaKishorM/laya)
- Laya 모델 카드 (Hugging Face, convaiinnovations/laya)
- Laya: an open source alternative to TypeSafe AI’s Jev (iMasters)
- Jev vs Laya: Hosted API or Open Weights? (Hugging Face 블로그)
// reading compass
이 글과 이어지는 경로
시리즈, 카테고리, 태그 겹침, 최신도를 점수화해 가까운 글일수록 중심에 배치합니다.
댓글남기기