Virtual Thread, 실무에 붙이기 전에 알아야 할 것들 [2/2]
SERIES Java Virtual Thread 완전 정복 2 / 2
- 1 자바 Virtual Thread 완전 정리: 원리, 성능, 그리고 2026년 현재 상태 [1/2]
- ▶ Virtual Thread, 실무에 붙이기 전에 알아야 할 것들 [2/2]
1편에서 Virtual Thread의 동작 원리와 실험 결과, 2026년 현재 기준 최신 업데이트(JDK 24의 pinning 해결, JDK 25의 Scoped Value finalize)까지 정리했습니다. 이번 편은 “그래서 우리 서비스에 진짜 붙여도 되나”에 답하기 위한 실무 관점 자료입니다 — 장단점 심층 분석, 실제 프로덕션 장애 사례, 다른 동시성 모델과의 비교, 도입 체크리스트 순으로 정리했습니다.
장점 vs 단점, 실무 관점에서 다시 보기
1편이 개념과 벤치마크 위주였다면, 여기서는 “실무에 붙였을 때 실제로 부딪히는 지점” 기준으로 다시 정리했습니다.
| 구분 | 내용 |
|---|---|
| 장점 — 코드 변경 없음 | 기존 블로킹 코드, JDBC, RestTemplate 등을 그대로 쓰면서 처리량만 올릴 수 있다. 리액티브로 전면 재작성할 필요가 없다. |
| 장점 — 러닝커브 최저 | 코틀린 코루틴이나 웹플럭스 대비 팀 전체가 새 패러다임을 배울 필요가 없다. 설정 한 줄로 시작 가능. |
| 장점 — IO 바운드에서 확실한 처리량 이득 | 1편 실측 기준 IO 바운드 51%↑. 블로킹 타임이 병목인 서비스에는 즉각적 효과. |
| 단점 — 관찰 가능성(observability) 저하 | 수만 개의 Virtual Thread가 뜨는 순간 기존 스레드 덤프, APM 툴의 스레드별 모니터링이 무의미해진다. 스레드 이름 기반 로깅·디버깅 관행이 깨진다. |
| 단점 — 병목이 다운스트림으로 이동 | 톰캣 스레드풀이라는 자연스러운 배압(backpressure)이 사라지면서, DB 커넥션 풀·레이트리밋·파일 디스크립터 같은 다운스트림 유한 리소스가 새로운 병목이 된다. |
단점 — ThreadLocal 캐싱 패턴이 조용히 깨짐 |
아래 사례 참고 — ThreadLocal.withInitial()로 값을 캐싱하던 코드가 Virtual Thread 환경에서는 캐시 히트율이 폭락하며 GC 압박으로 나타난다. |
| 단점 — 라이브러리 생태계 성숙도 | JDK 24 이전 버전의 JDBC 드라이버, 일부 트레이싱/로깅 라이브러리는 내부적으로 synchronized를 쓰고 있어 pinning을 유발했다(JDK 24+에서는 대부분 해소). |
| 단점 — CPU 바운드에는 오히려 손해 | 1편 실측 기준 CPU 바운드 -7%. 스케줄링·생성 오버헤드만 추가된다. |
실제 프로덕션 장애/운영 사례 3가지
사례 1 — Netflix, 트레이싱 라이브러리의 synchronized가 4개 코어를 마비시킴
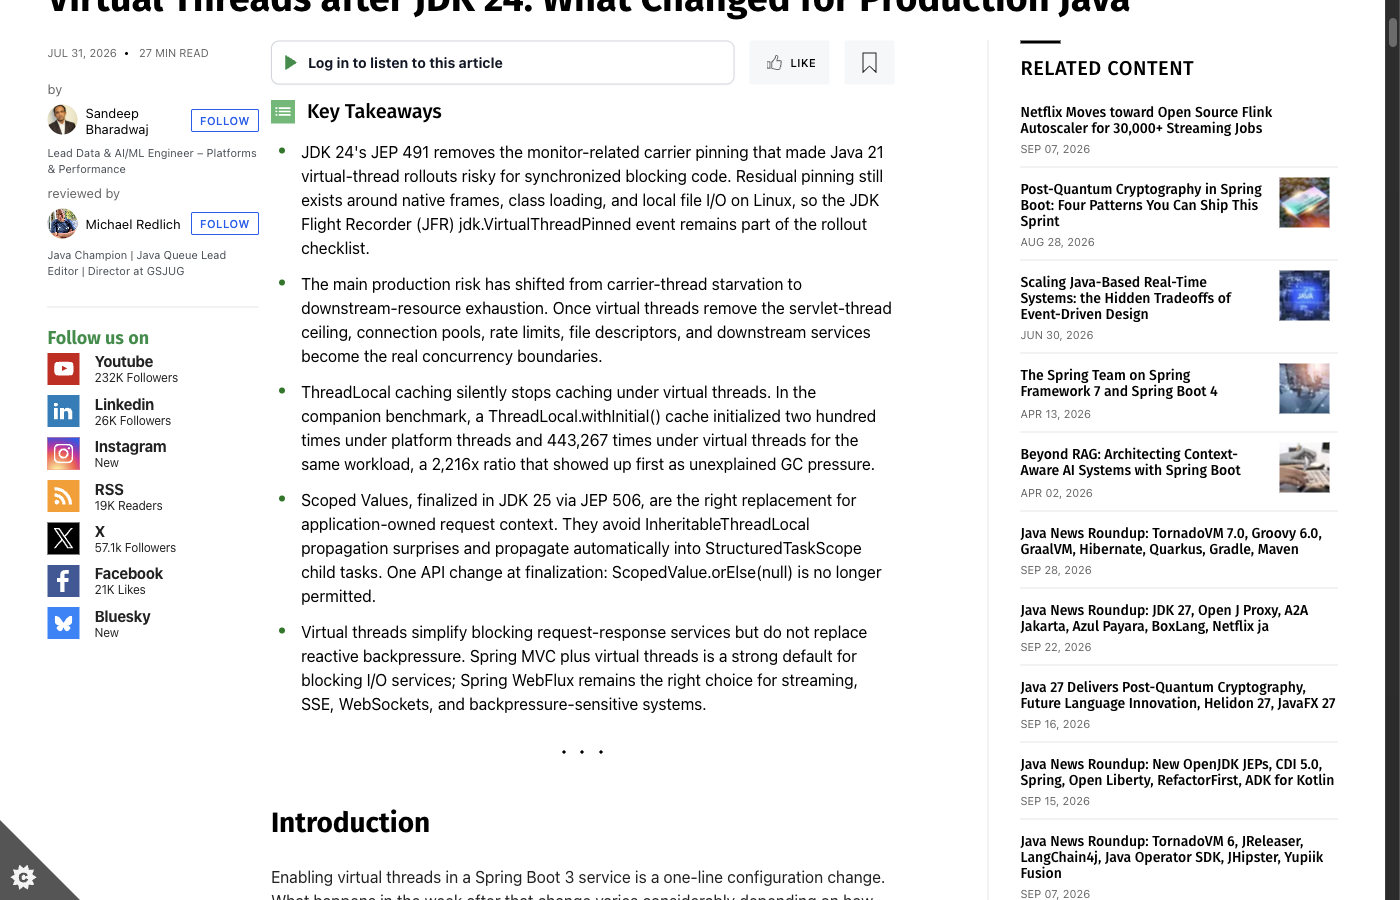
2024년(JDK 21 시절), Netflix의 한 서비스가 4vCPU 인스턴스에서 운영 중 정지 현상을 겪었습니다. 원인은 내부적으로 synchronized 블록을 쓰는 트레이싱 라이브러리(brave.RealSpan.finish())였습니다. 4vCPU 환경이라 JVM의 ForkJoinPool 캐리어 스레드가 정확히 4개였는데, 4개의 Virtual Thread가 동시에 그 락을 기다리며 4개 캐리어 스레드에 모두 핀(pin)되어 버렸고, 결과적으로 서버 전체가 새 요청을 처리할 캐리어 스레드가 하나도 남지 않게 됐습니다. JDK 24의 JEP 491(모니터를 캐리어가 아닌 Virtual Thread 자체에 연결)이 이 유형의 장애를 근본적으로 제거했습니다.
해결 방법. 가장 확실한 해결책은 JDK 24+로 올리는 것(JEP 491이 근본 원인을 제거)이지만, 당장 업그레이드가 어렵다면 문제가 된 구간만 synchronized에서 ReentrantLock으로 국소 교체하면 JDK 21~23에서도 pinning 없이 동작합니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
// Before — synchronized 블록 안에서 블로킹 호출(트레이싱 span 종료 등) → pinning 유발
public synchronized void finishSpan(Span span) {
    span.tag("result", callDownstream()); // 블로킹 I/O
    spans.remove(span.id());
}

// After — ReentrantLock으로 교체. 블로킹이 발생해도 캐리어 쓰레드가 풀려난다
private final ReentrantLock lock = new ReentrantLock();

public void finishSpan(Span span) {
    lock.lock();
    try {
        span.tag("result", callDownstream());
        spans.remove(span.id());
    } finally {
        lock.unlock();
    }
}
사례 2 — “처리량이 정확히 초당 421건에서 멈췄다”
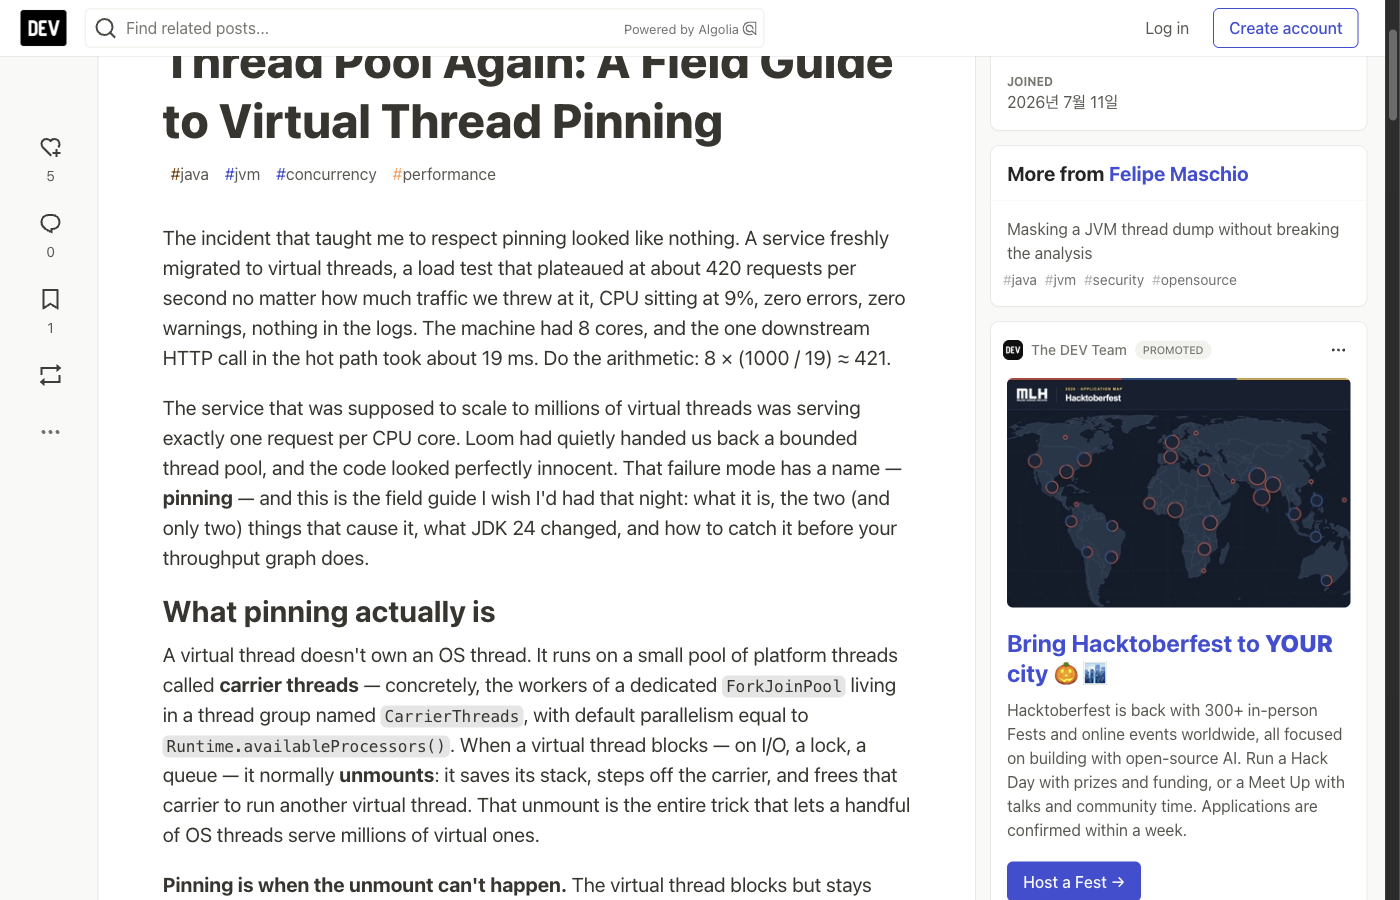
한 팀이 서비스를 Virtual Thread로 마이그레이션한 뒤 부하 테스트를 돌렸는데, 트래픽을 아무리 늘려도 처리량이 초당 약 420건에서 정체됐습니다. CPU 사용률은 9%, 에러도 경고도 로그에 없었습니다. 원인을 찾아보니 — 서버는 8코어였고, 핫패스에 있는 다운스트림 HTTP 호출 하나가 19ms 걸렸습니다. 8 × (1000 / 19) ≈ 421. 즉 Virtual Thread가 CPU 코어당 정확히 하나씩만 배정된 캐리어 스레드에 핀(pin)되어 있었던 겁니다 — “수백만 개로 확장돼야 할 서비스가 CPU 코어 수만큼만 요청을 처리하고 있었다”는 표현이 이 상황을 정확히 짚습니다.
해결 방법. 이 사례가 무서운 이유는 에러도 경고도 없었다는 점입니다 — 진단하려면 JFR로 pinning 이벤트를 실시간으로 구독해서 스택트레이스를 확보해야 합니다.
1
2
3
4
5
6
7
8
9
10
11
// JFR 스트림으로 pinning 이벤트를 실시간 구독 — 애플리케이션 구동 시 등록
try (RecordingStream rs = new RecordingStream()) {
    rs.enable("jdk.VirtualThreadPinned").withStackTrace();
    rs.onEvent("jdk.VirtualThreadPinned", event -> {
        log.warn("Virtual Thread pinned for {}ms\n{}",
                event.getDuration().toMillis(),
                event.getStackTrace());
    });
    rs.startAsync();
    // ... 애플리케이션 로직
}
이렇게 확보한 스택트레이스가 특정 synchronized 블록이나 native 메서드를 가리키면, 사례 1과 동일하게 ReentrantLock으로 교체하거나 해당 라이브러리를 pinning-free 버전으로 올리면 됩니다.
사례 3 — ThreadLocal 캐싱이 조용히 무력화되며 GC 압박으로 나타남
ThreadLocal.withInitial()로 비싼 객체를 캐싱해 재사용하던 코드가 있었습니다. 플랫폼 쓰레드에서는 쓰레드풀이 재사용되니 캐시가 200번만 초기화되면 됐는데, 같은 워크로드를 Virtual Thread에서 돌리자 캐시가 443,267번 초기화됐습니다(2,216배). Virtual Thread는 요청마다 새로 생성·소멸되기 때문에 ThreadLocal 캐시가 매번 새로 만들어진 것입니다. 에러도 없이 그냥 GC 압박으로만 나타나서 원인 추적이 까다로웠던 사례입니다. 1편에서 다룬 “경량 쓰레드는 가볍게 유지해야 한다”는 주의사항이 실제로 이런 형태로 터집니다 — 해결책은 JDK 25에서 finalize된 ScopedValue로 옮기는 것입니다.
해결 방법. 이 코드가 ThreadLocal을 쓴 의도가 “요청마다 값을 캐싱해서 재사용”이었는지, 아니면 “요청 범위 컨텍스트를 전파”였는지에 따라 고쳐야 할 방향이 다릅니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// Before — 매 요청(Virtual Thread)마다 새로 생성되어 캐싱 효과가 사라짐
private static final ThreadLocal<ExpensiveParser> PARSER_CACHE =
        ThreadLocal.withInitial(ExpensiveParser::new); // 200번 vs 443,267번 초기화

// After A — 진짜 "재사용 가능한 비싼 객체" 캐싱이 목적이었다면,
// 쓰레드가 아니라 키 기준으로 공유하는 풀로 분리한다 (thread-safe 객체 전제)
private static final ConcurrentHashMap<String, ExpensiveParser> PARSER_POOL =
        new ConcurrentHashMap<>();

ExpensiveParser parser = PARSER_POOL.computeIfAbsent(schemaKey, k -> new ExpensiveParser());

// After B — "요청 범위 컨텍스트 전파"가 목적이었다면 ScopedValue로 교체한다 (JDK 25+)
private static final ScopedValue<RequestContext> CONTEXT = ScopedValue.newInstance();

ScopedValue.where(CONTEXT, new RequestContext(userId, traceId))
           .run(() -> handleRequest()); // 블록을 벗어나면 자동 해제, 매번 새로 만들어도 GC 부담 없음
ThreadLocal은 “이 쓰레드가 살아있는 동안 값을 들고 있는다”는 게 핵심이라 매번 죽고 태어나는 Virtual Thread와는 상성이 나쁩니다. 캐싱이 목적이면 캐시답게 쓰레드와 무관한 자료구조로, 컨텍스트 전파가 목적이면 ScopedValue로 — 이 둘을 구분하는 게 이 사례를 막는 핵심입니다.
다른 동시성 모델과 비교 — 언제 뭘 써야 하나
| Virtual Thread | Kotlin Coroutine | WebFlux (Reactor) | |
|---|---|---|---|
| 패러다임 | 쓰레드 단위 스케줄링 최적화 | 메서드(루틴) 단위 스케줄링 | 함수형·이벤트 기반 논블로킹 파이프라인 |
| 코드 변경 범위 | 거의 없음 (설정/실행자만 교체) | 언어 자체 학습 필요 (suspend, 코루틴 스코프) |
전체 스택 재작성 필요 (Mono/Flux) |
| 구조화된 동시성 | 프리뷰 (JDK 26, 6th preview) | 정식 지원 (구조화된 동시성 원조) | 자체 연산자 체인으로 처리 |
| 배압(backpressure) | 없음 — 애플리케이션에서 직접 구현 | 채널/플로우로 지원 | 1급 시민 기능 |
| 취소/타임아웃 | StructuredTaskScope로 프리뷰 지원 |
withTimeout, coroutineScope로 명확 |
연산자(timeout())로 지원 |
| 가장 잘 맞는 상황 | 기존 블로킹 코드가 많은 레거시/서블릿 스택, 팀의 러닝커브 최소화 | 코틀린 기반 신규 프로젝트, 복잡한 동시성 제어가 필요할 때 | 극단적으로 높은 동시 연결(수십만 커넥션), 스트리밍/SSE/웹소켓 |
| 피해야 할 상황 | CPU 바운드, WebFlux와 혼용 | — | 블로킹 코드가 섞인 팀, 러닝커브 부담 큰 팀 |
핵심은 “무엇이 더 나은가”가 아니라 “이미 가진 스택과 팀 역량에 뭐가 자연스러운가”입니다. 자바 팀이고 블로킹 코드가 이미 많다면 Virtual Thread가 가장 마찰이 적은 선택지, 코틀린 팀이고 복잡한 동시성 제어(취소·타임아웃·구조화)가 중요하다면 코루틴, 수십만 단위 동시 연결이나 스트리밍이 핵심이라면 WebFlux가 낫습니다.
도입 전 체크리스트
-
커넥션 풀 크기를 Virtual Thread 개수가 아니라 다운스트림 용량 기준으로 재설정한다. HikariCP, HTTP 클라이언트 풀, Redis 풀 모두 대상. 풀 크기보다 많은 동시 요청이 들어오면 풀 고갈(사례 2·3의 근본 원인)로 이어진다. 무제한으로 대기시키기보다 타임아웃을 두고 빨리 실패시키는 편이 안전하다.
1
2
3
4
5
6
7
8
9
10
11
12
private final Semaphore downstreamPermits = new Semaphore(poolSize);

public Order fetchOrder(long id) {
    if (!downstreamPermits.tryAcquire(200, TimeUnit.MILLISECONDS)) {
        throw new DownstreamOverloadedException(); // 무한 대기 대신 즉시 실패 → 장애 전파 차단
    }
    try {
        return orderRepository.findById(id);
    } finally {
        downstreamPermits.release();
    }
}
- JFR로 pinning을 확인한다. JDK 24 이전이면
-Djdk.tracePinnedThreads=full, JDK 24 이후는 JFRjdk.VirtualThreadPinned이벤트로 native 프레임·클래스 로딩·리눅스 로컬 파일 IO로 인한 잔여 pinning을 확인한다. synchronized의존 라이브러리 버전을 점검한다. JDBC 드라이버, 트레이싱 라이브러리 등은 JDK 24+ 버전으로 맞추고, 그래도 pinning이 남아있다면 해당 구간만ReentrantLock으로 국소적으로 교체한다.ThreadLocal캐싱 패턴을 전수 점검한다. 요청 범위 컨텍스트는ScopedValue(JDK 25+)로 옮기고, 진짜 캐시가 필요한 곳은 별도의 정적 캐시 구조로 분리한다.- JDK, Spring Boot, HTTP 클라이언트, DB 드라이버, 동시성 모델을 한 릴리스에서 동시에 바꾸지 않는다. 문제가 생겼을 때 원인을 좁히기 어려워진다.
- 트래픽 대표성이 있는 서비스 하나(카나리)에 먼저 적용하고, 플랫폼 쓰레드로 되돌릴 수 있는 배포 스위치를 유지한다. 되돌릴 수 없는 아키텍처 전환이 아니라 런타임 설정값으로 다루는 편이 안전하다.
- 최소 JDK 24, 가능하면 LTS인 JDK 25 이상을 기준으로 검토한다. 1편에서 다룬 것처럼 JDK 21 시절의 pinning 경고 상당수가 JDK 24+에서는 더 이상 유효하지 않다.
결론
Virtual Thread는 “공짜 성능”이 아닙니다. 도입 장벽(코드 변경)은 확실히 낮아졌지만, 병목이 사라지는 게 아니라 톰캣 스레드풀에서 다운스트림 리소스로 이동할 뿐입니다. 위 세 가지 실제 사례가 공통적으로 보여주는 건 하나입니다 — 문제는 대부분 에러 로그 없이, 처리량 정체나 GC 압박 같은 조용한 신호로만 나타납니다. 체크리스트의 관찰 가능성(JFR)과 배압(커넥션 풀) 항목을 가장 먼저 챙기시길 권합니다.
// reading compass
이 글과 이어지는 경로
시리즈, 카테고리, 태그 겹침, 최신도를 점수화해 가까운 글일수록 중심에 배치합니다.
댓글남기기