Jev로 하루 업무 자동화하기: 실전 워크플로우 4가지 [4/4]
SERIES TypeSafe Jev 완전 정복 4 / 4
- 1 전세계가 주목하는 AI 'Jev', 5분이면 이해합니다 — TypeSafe Jev 입문 [1/4]
- 2 Jev, 진짜 8배 빠르고 76배 저렴할까? 직접 테스트해봤다 [2/4]
- 3 Jev 모델 파헤치기: 구조, 원리, 그리고 활용법 [3/4]
- ▶ Jev로 하루 업무 자동화하기: 실전 워크플로우 4가지 [4/4]
Jev 시리즈의 마지막 편입니다. 유튜브 채널 시민개발자 구시의 “요즘 가장 핫한 AI모델 Jev, AI 자동화에 적용하기!” 영상을 바탕으로, 앞선 입문·벤치마크·구조 분석 편에서 다룬 Jev를 실제 업무 워크플로우에 어떻게 붙이는지 정리했습니다.
셋업은 세 단계
Jev를 실제로 쓰려면 준비할 게 세 가지뿐입니다 — 스킬(사용 설명서) · API 키(인증) · 코드(실제 호출). 연결 경로는 TypeSafe 공식, OpenRouter, Vercel AI Gateway 세 가지가 있는데, 영상은 TypeSafe 공식 경로를 기준으로 보여줍니다.
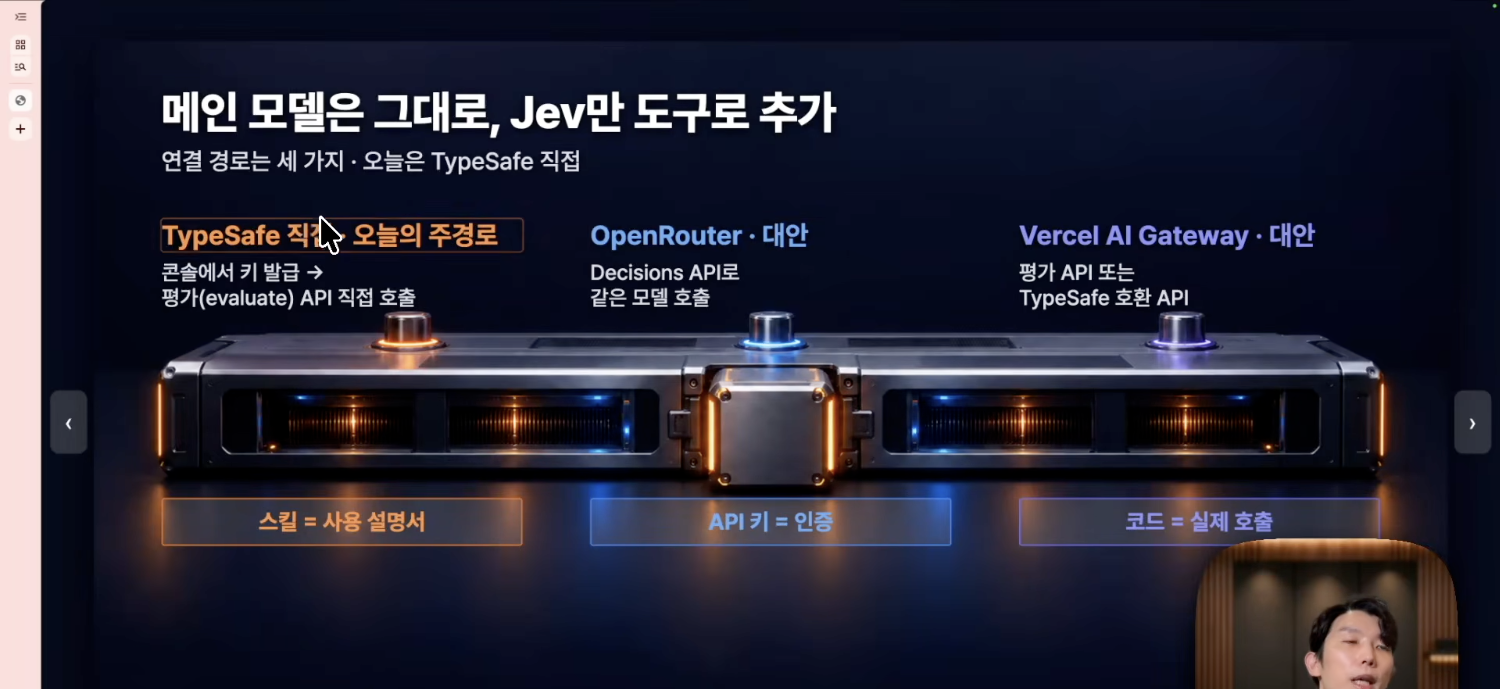
1. API 키 발급. typesafe.ai에서 회원가입 후 API 콘솔로 들어가면 API 키 발급 섹션이 있습니다. “Create Key”를 누르면 바로 키가 생성되니 그대로 복사해서 안전한 곳에 저장해둡니다.
2. 스킬 설치. typesafe.ai 홈 화면 우측에 “Quickstart” 섹션이 있는데, 여기 있는 설치 프롬프트를 그대로 복사해서 에이전트에게 붙여넣으면 됩니다.
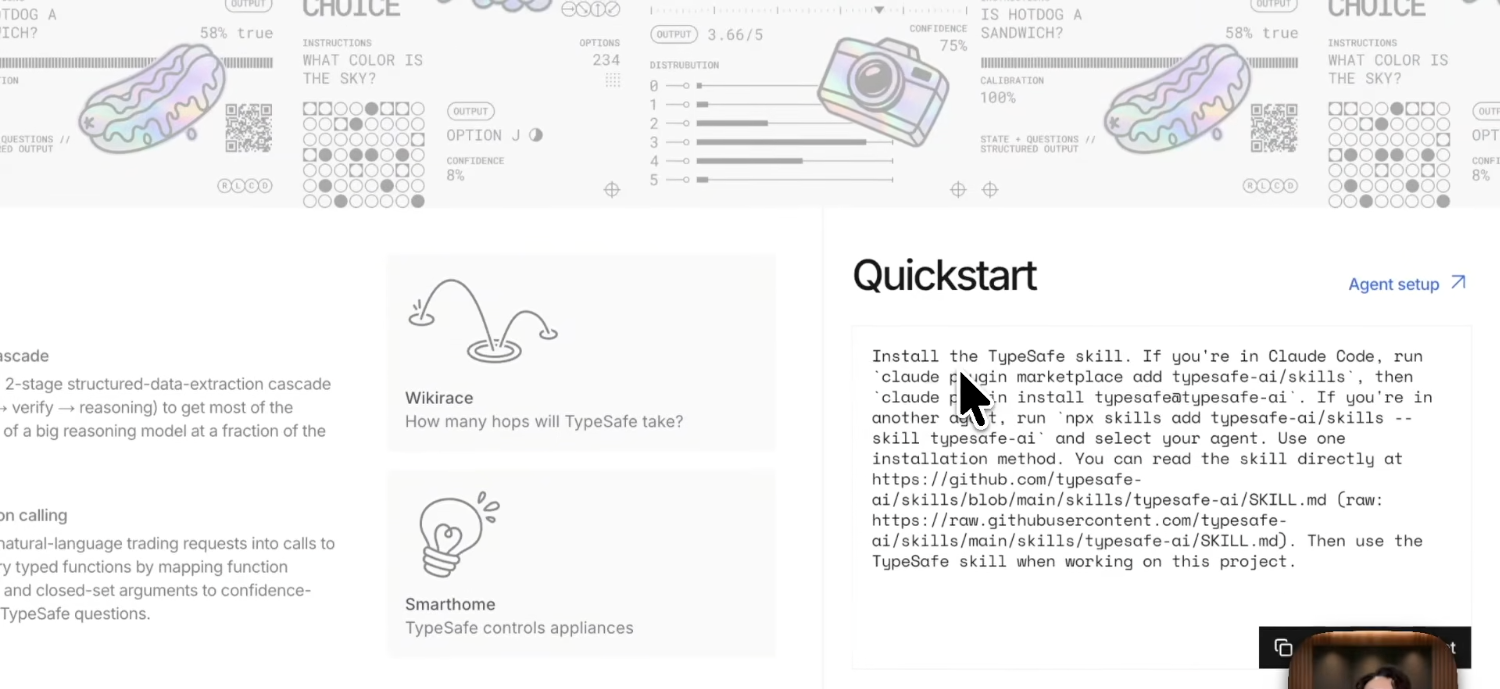
Claude Code라면 claude plugin marketplace add typesafe-ai/skills 후 claude plugin install typesafe@typesafe-ai, 다른 에이전트는 npx skills add typesafe-ai/skills --skill typesafe-ai. 영상에서 실제로 쓴 프롬프트는 이런 식입니다:
이 프로젝트에서 Jev를 활용할 수 있도록 TypeSafe 공식 스킬을 설치해줘. 설치 명령은 다음과 같다: (위 명령어). 설치 대상은 코덱스만, 범위는 현재 프로젝트로 선택해줘. 설치된 스킬 MD를 읽고 앞으로 이 프로젝트에서 Jev 기능을 만들 때 이 스킬과 최신 TypeSafe 공식 문서를 참고해줘.
이 스킬을 읽어야 에이전트가 Jev 활용법(판단 방식, 토큰 리밋, 응답 포맷 등)을 참고해서 실수 없이 코드를 짤 수 있습니다. 헤르메스 에이전트 같은 상시 구동 에이전트도 동일한 방식으로 프롬프트만 살짝 바꿔서 요청하면 됩니다.
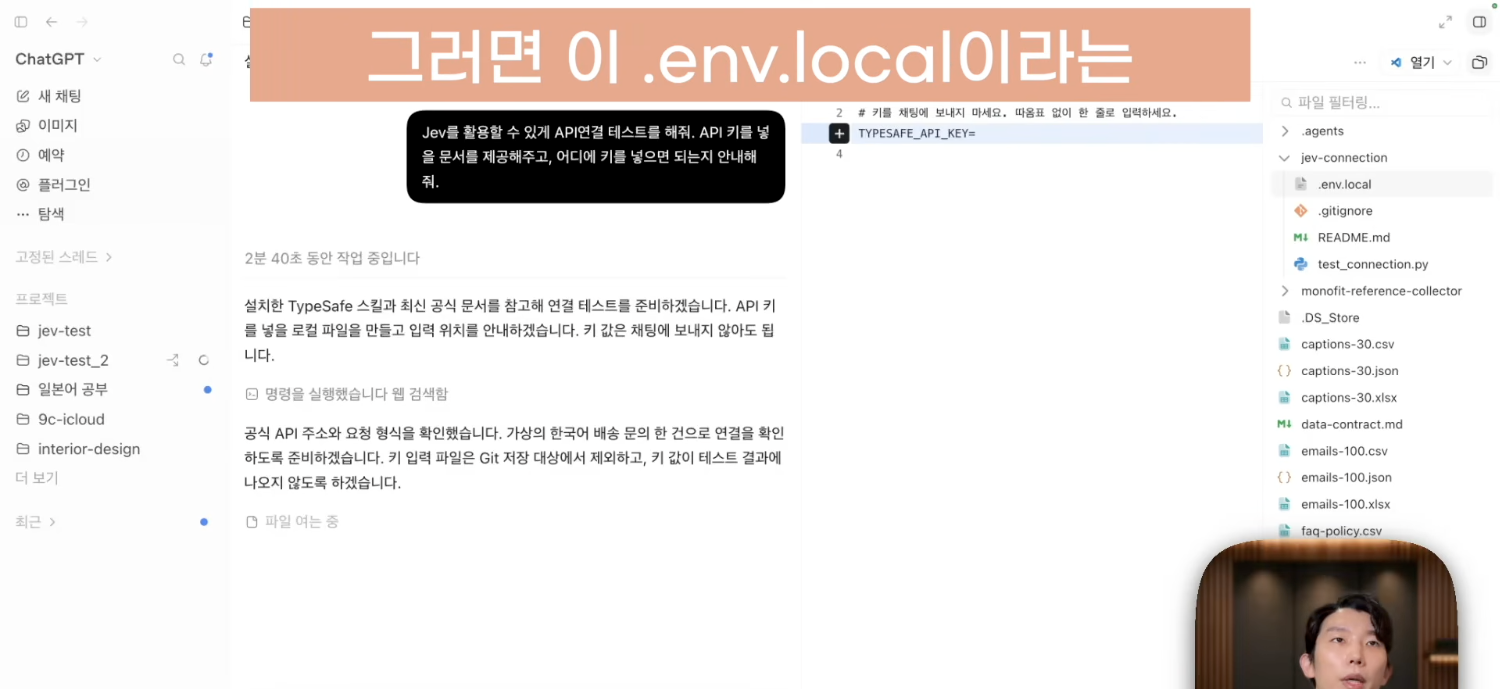
3. API 연동. 발급받은 키를 AI에게 직접 넘기지 말고, 직접 .env 문서에 입력하는 게 안전합니다. 영상에서는 이렇게 요청합니다:
Jev를 활용할 수 있게 API 연결 테스트를 해줘. API 키를 넣을 문서를 제공해주고, 어디에 키를 넣으면 되는지 안내해줘.
그러면 에이전트가 .env.local 같은 파일을 만들고 어디에 키를 넣으면 되는지 알려줍니다. 키 값 자체는 채팅에 노출되지 않도록 파일에만 저장하고, 저장 완료 후 “연결 테스트해줘”라고 요청하면 실제 API 인증과 응답까지 확인해줍니다.
실전 사례 1 — 고객 문의 1,000건 분류 + 모델 라우팅
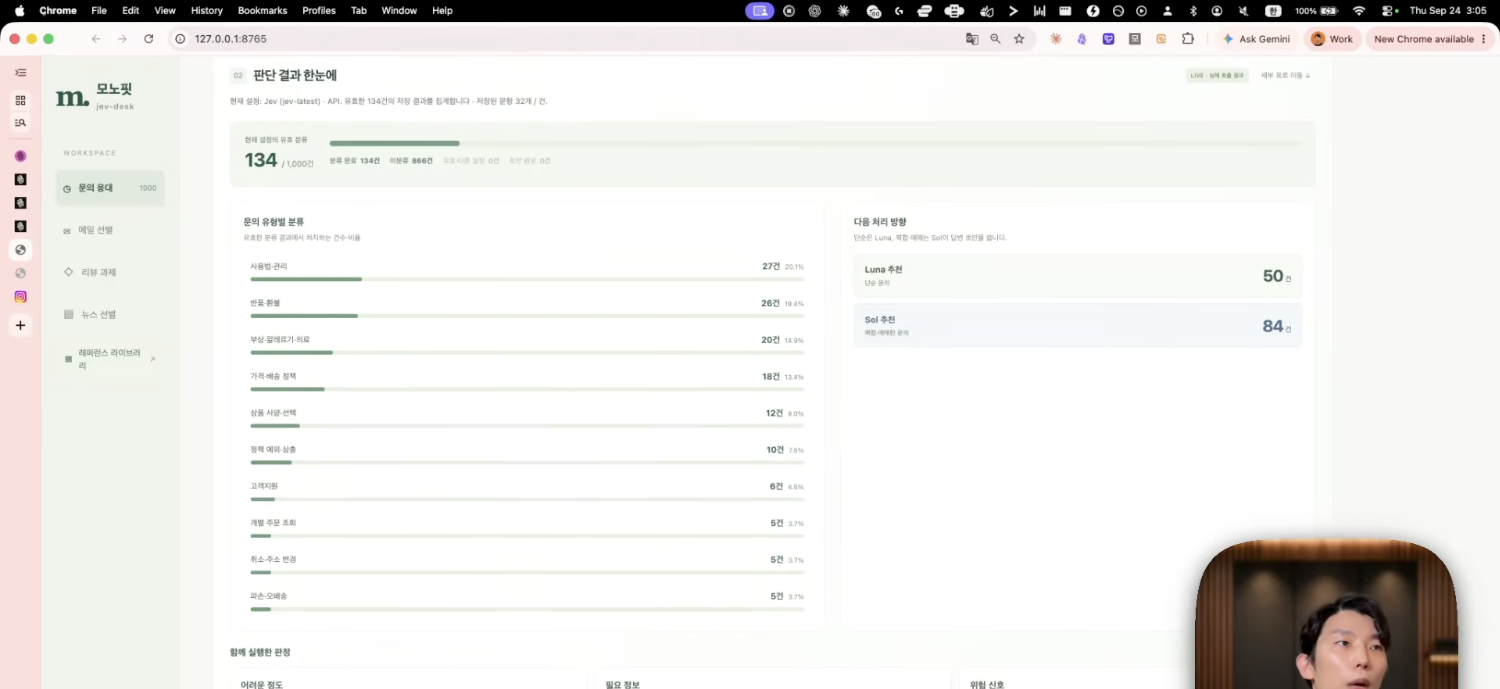
고객 문의를 Jev로 먼저 분류한 뒤, 단순 문의는 저가 모델(GPT Luna)에게, 복잡한 문의는 상위 모델(GPT Sol)에게 답변 초안을 맡긴다. 분류 자체를 프론티어 모델에게 시키면 시간과 비용이 크지만, Jev는 병렬로 판정만 하기 때문에 1,000건 중 200건을 테스트했을 때도 체감상 즉시 처리됐다.
실전 사례 2 — 이메일 초안 작성 필요 여부 필터링
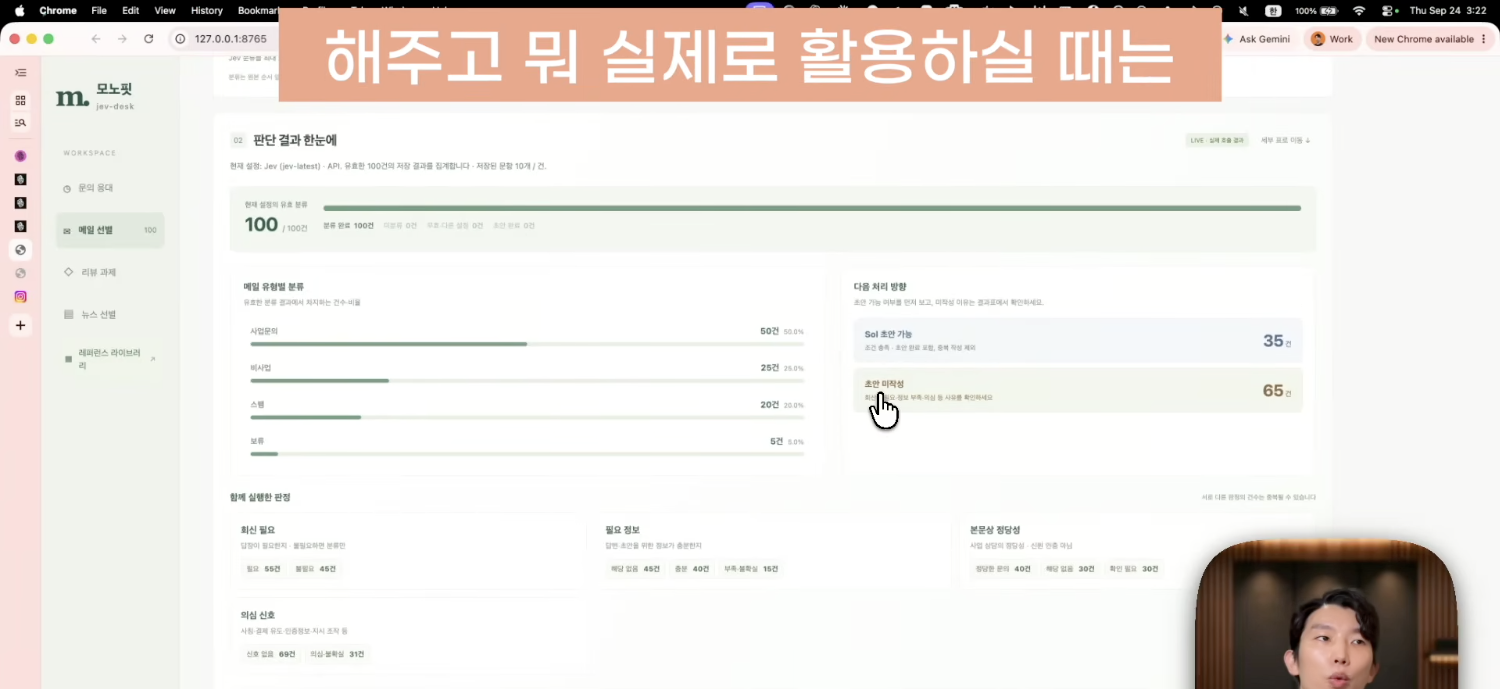
모든 메일에 답장 초안을 만들 필요는 없다. 스팸이나 사업 문의가 아닌 메일을 Jev가 먼저 걸러내고, 답장이 필요한 메일만 다음 단계(초안 작성)로 넘긴다.
실전 사례 3 — 리뷰 500건에서 개선 과제 도출
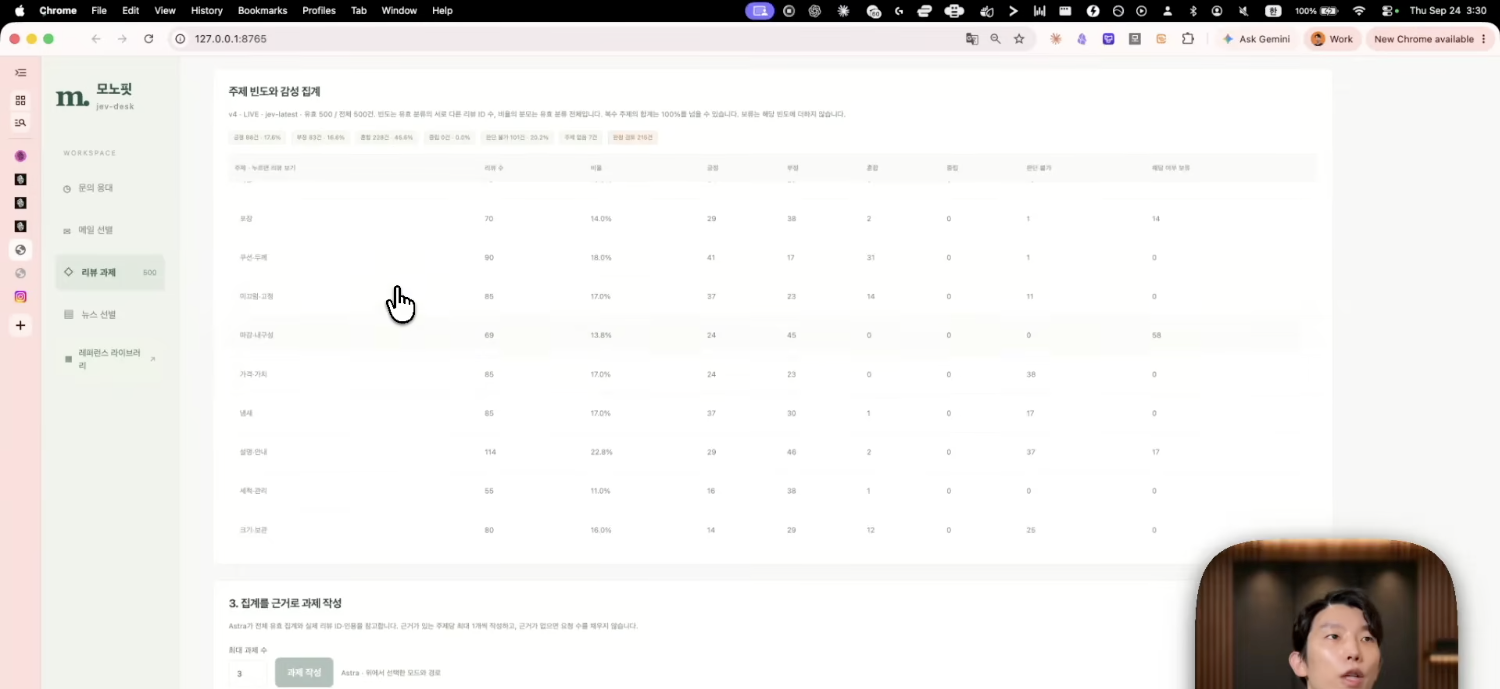
리뷰 30건을 프론티어 모델로 먼저 훑어 분류 기준을 만들고, 그 기준으로 나머지 리뷰 500건을 Jev가 분류한다. 부정·혼합 리뷰만 추려서 실제 개선 과제 3개를 뽑아내는 식 — 긍정 리뷰까지 전부 프론티어 모델에 태울 필요가 없다는 게 핵심.
실전 사례 4 — 뉴스 500건 큐레이션
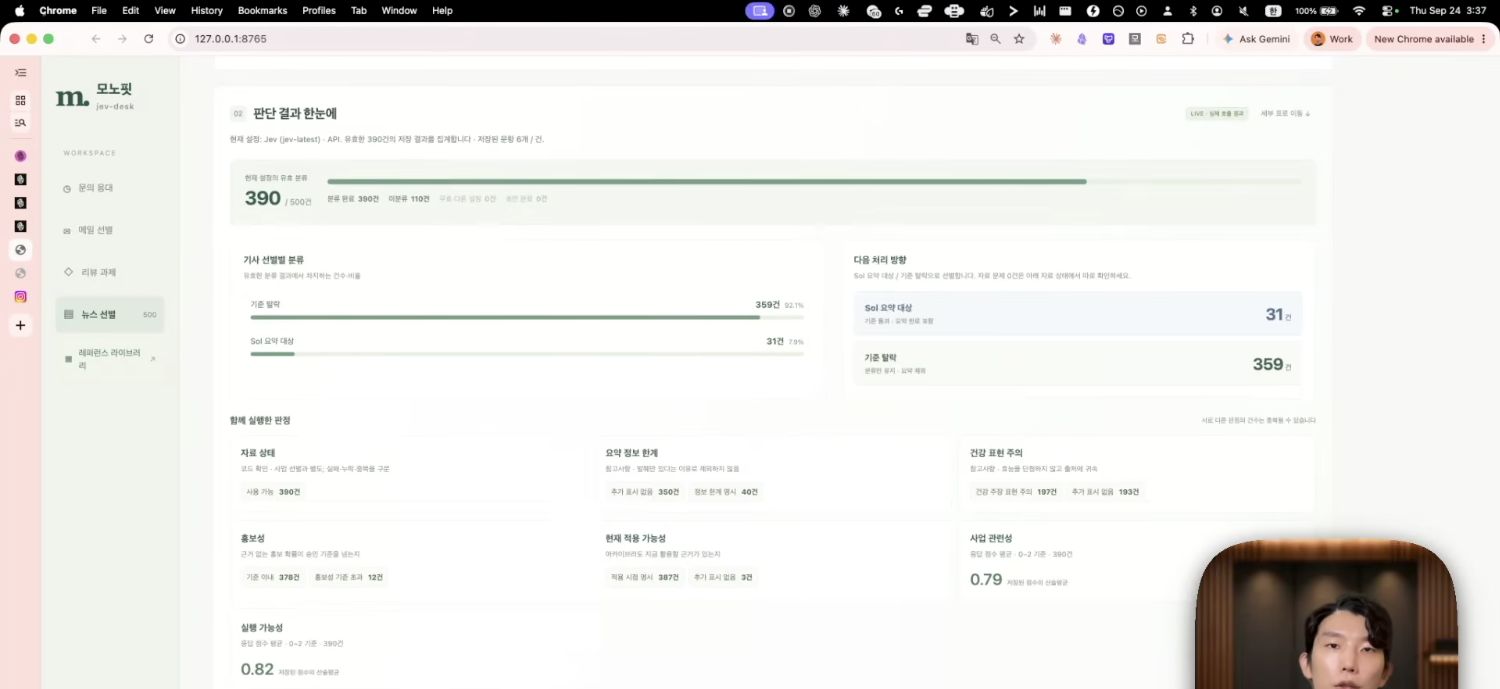
크롤링해 온 뉴스 500건을 관심사 기준으로 Jev가 필터링하면 42건으로 줄어든다. 이 줄어든 결과만 요약 리포트로 만들면 되니, 전체를 프론티어 모델에 넣는 것보다 훨씬 빠르고 저렴하다.
보너스 — 인스타그램 스크롤하며 실시간 레퍼런스 수집
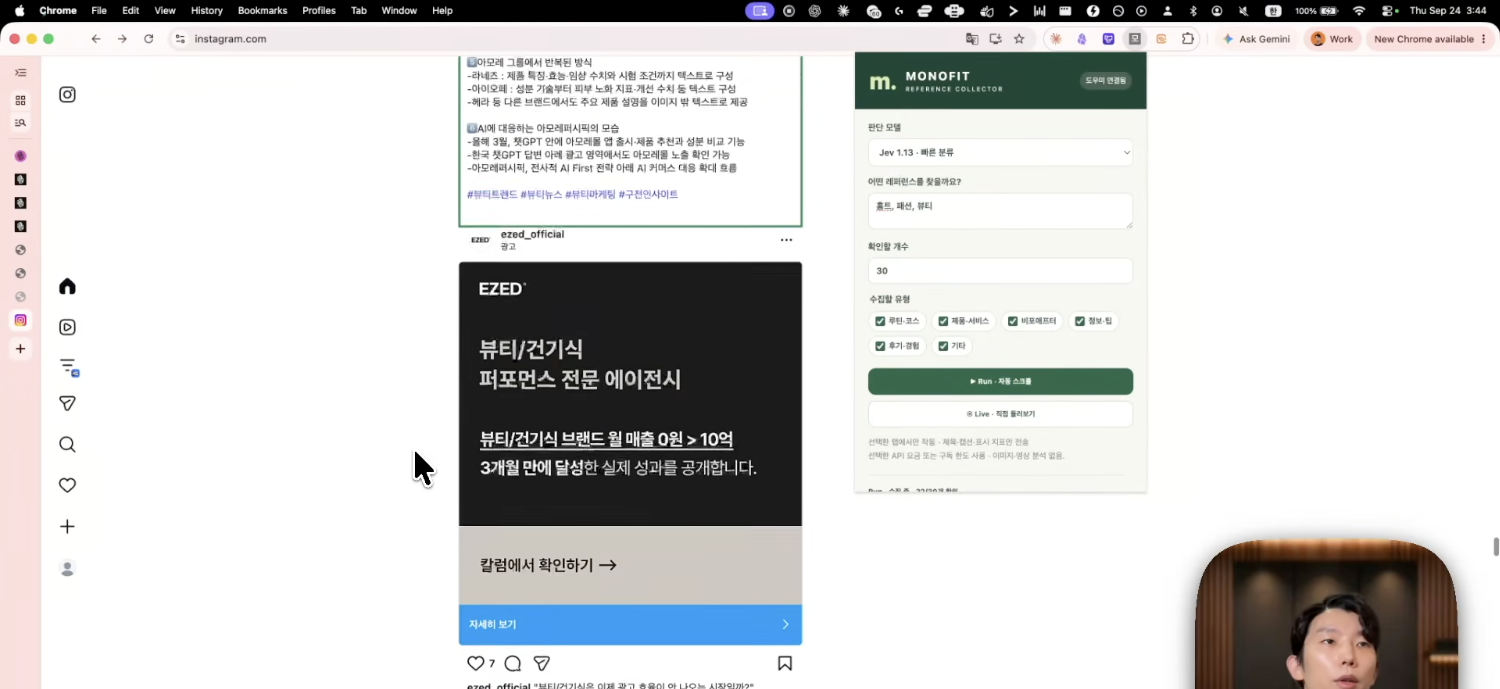
Astra로 만든 크롬 익스텐션과 Jev를 연동해, 인스타그램을 스크롤할 때마다 각 게시물이 레퍼런스로 쓸 만한지 실시간 판정한다. 관련 있으면 초록, 무관하면 빨강, 애매하면 노랑 테두리로 표시하고 초록 항목은 자동으로 스크랩된다.
언제 Jev를 쓰고, 언제 안 써야 하나
영상이 강조하는 지점은 하나다 — Jev는 대용량 판단·분류 작업에 강하지, 실시간 단발성 작업에는 오히려 손해일 수 있다. 코덱스나 헤르메스 에이전트 안에서 메인 모델(Astra 등)이 요청을 이해하고 Jev를 호출하는 구조라면, 메인 모델의 처리 속도가 병목이 되어 Jev의 장점(속도)이 죽는다. 그래서 반복되는 대량 작업이라면 앱으로 직접 Jev를 호출하거나, 크론으로 시간대별 자동화(9시 분류 → 10시 Luna 답변 → 11시 Sol 답변)를 걸어두는 편이 실질적으로 유용하다.
가입 시 $5 무료 크레딧이 제공되고, 이것만으로도 꽤 오래 테스트해볼 수 있다고 한다. 소량 데이터라면 굳이 Jev를 쓸 필요 없이 Astra나 다른 프론티어 모델로 충분하지만, 수백~수천 건 단위의 판단·분류 작업이라면 검토해볼 만하다.
// reading compass
이 글과 이어지는 경로
시리즈, 카테고리, 태그 겹침, 최신도를 점수화해 가까운 글일수록 중심에 배치합니다.
댓글남기기